产品偏好测试(MaxDiff)
MaxDiff模型的作用
MaxDiff模型要求受访者从多个选项中选择最具吸引力和最不具吸引力的选项,确定受访者最看重和最不看重的产品功能或服务。
问卷设计
(1)MaxDiff
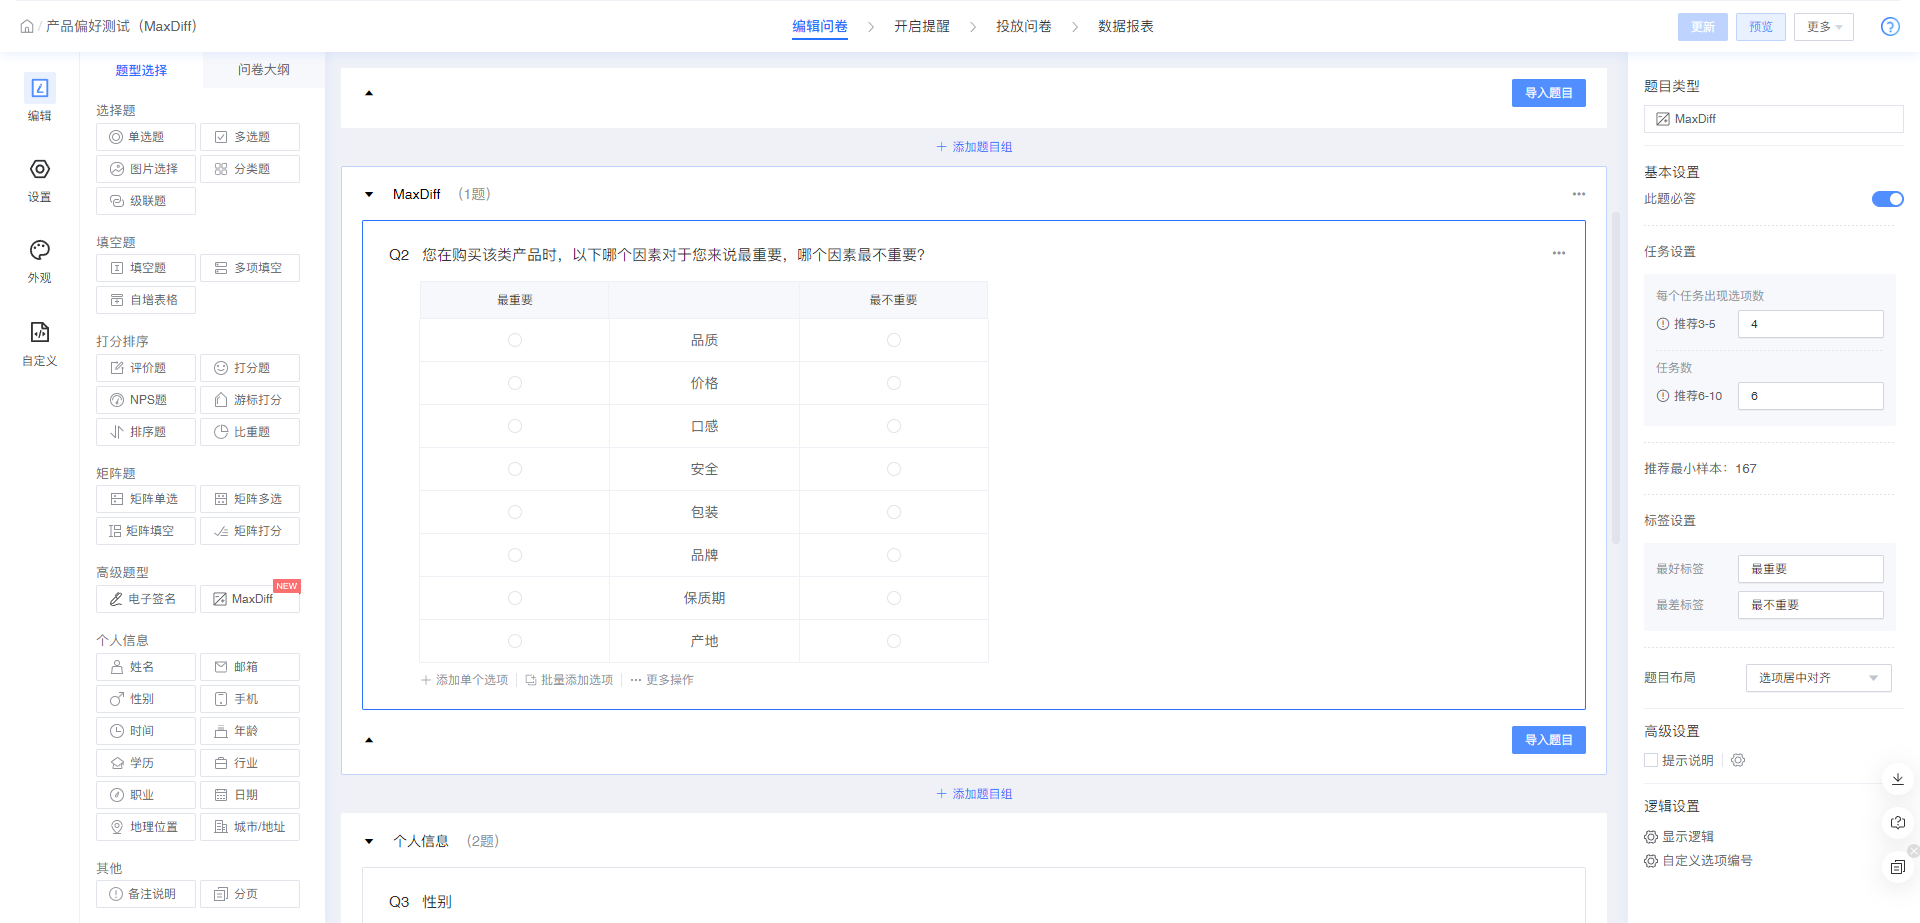
要求受访者在给定的选项之间进行多轮选择,每一轮选出一个最重要和最不重要的选项。一共进行几轮(即任务数)、每一轮比较几个选项,可以在任务设置中配置。根据选项数量和任务设置中的配置,系统会自动生成推荐的最小样本量。
(2)个人信息
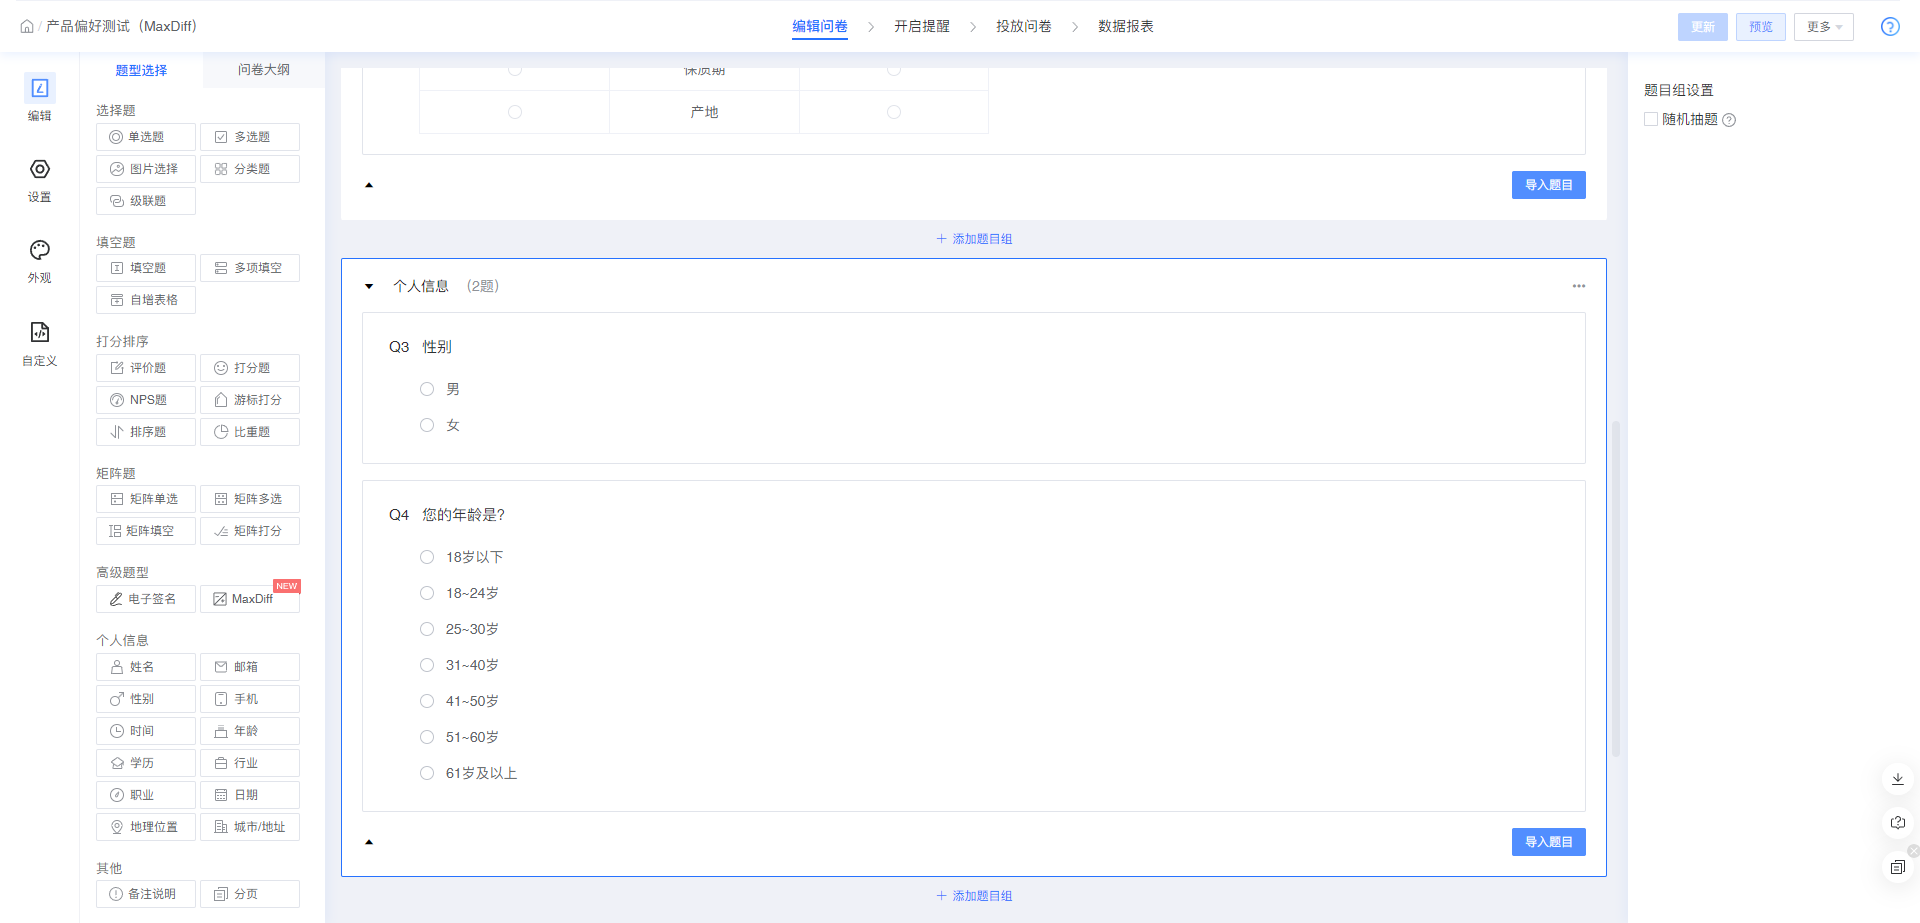
在实际项目中,MaxDiff常常需要拆分维度分析,性别和年龄是最常见的两个维度。当前按维度分析仅支持“个人信息”题目组中预置的性别题和年龄题。新增其他个人信息题或者删除预置的个人信息题,将不会生成对应的筛选器。
数据结构
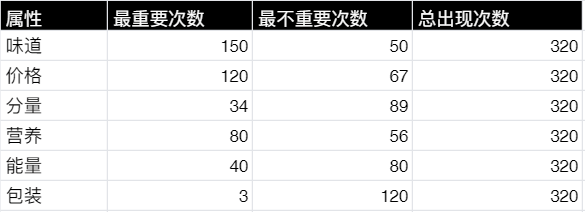
系统将回收的答卷数据解析为以下数据格式。
● 最重要次数:该属性被选为“最重要”的次数
● 最不重要次数:该属性被选为“最不重要”的次数
● 总出现次数:该属性被展示给受访者的总次数
分析报告
(1)样本量
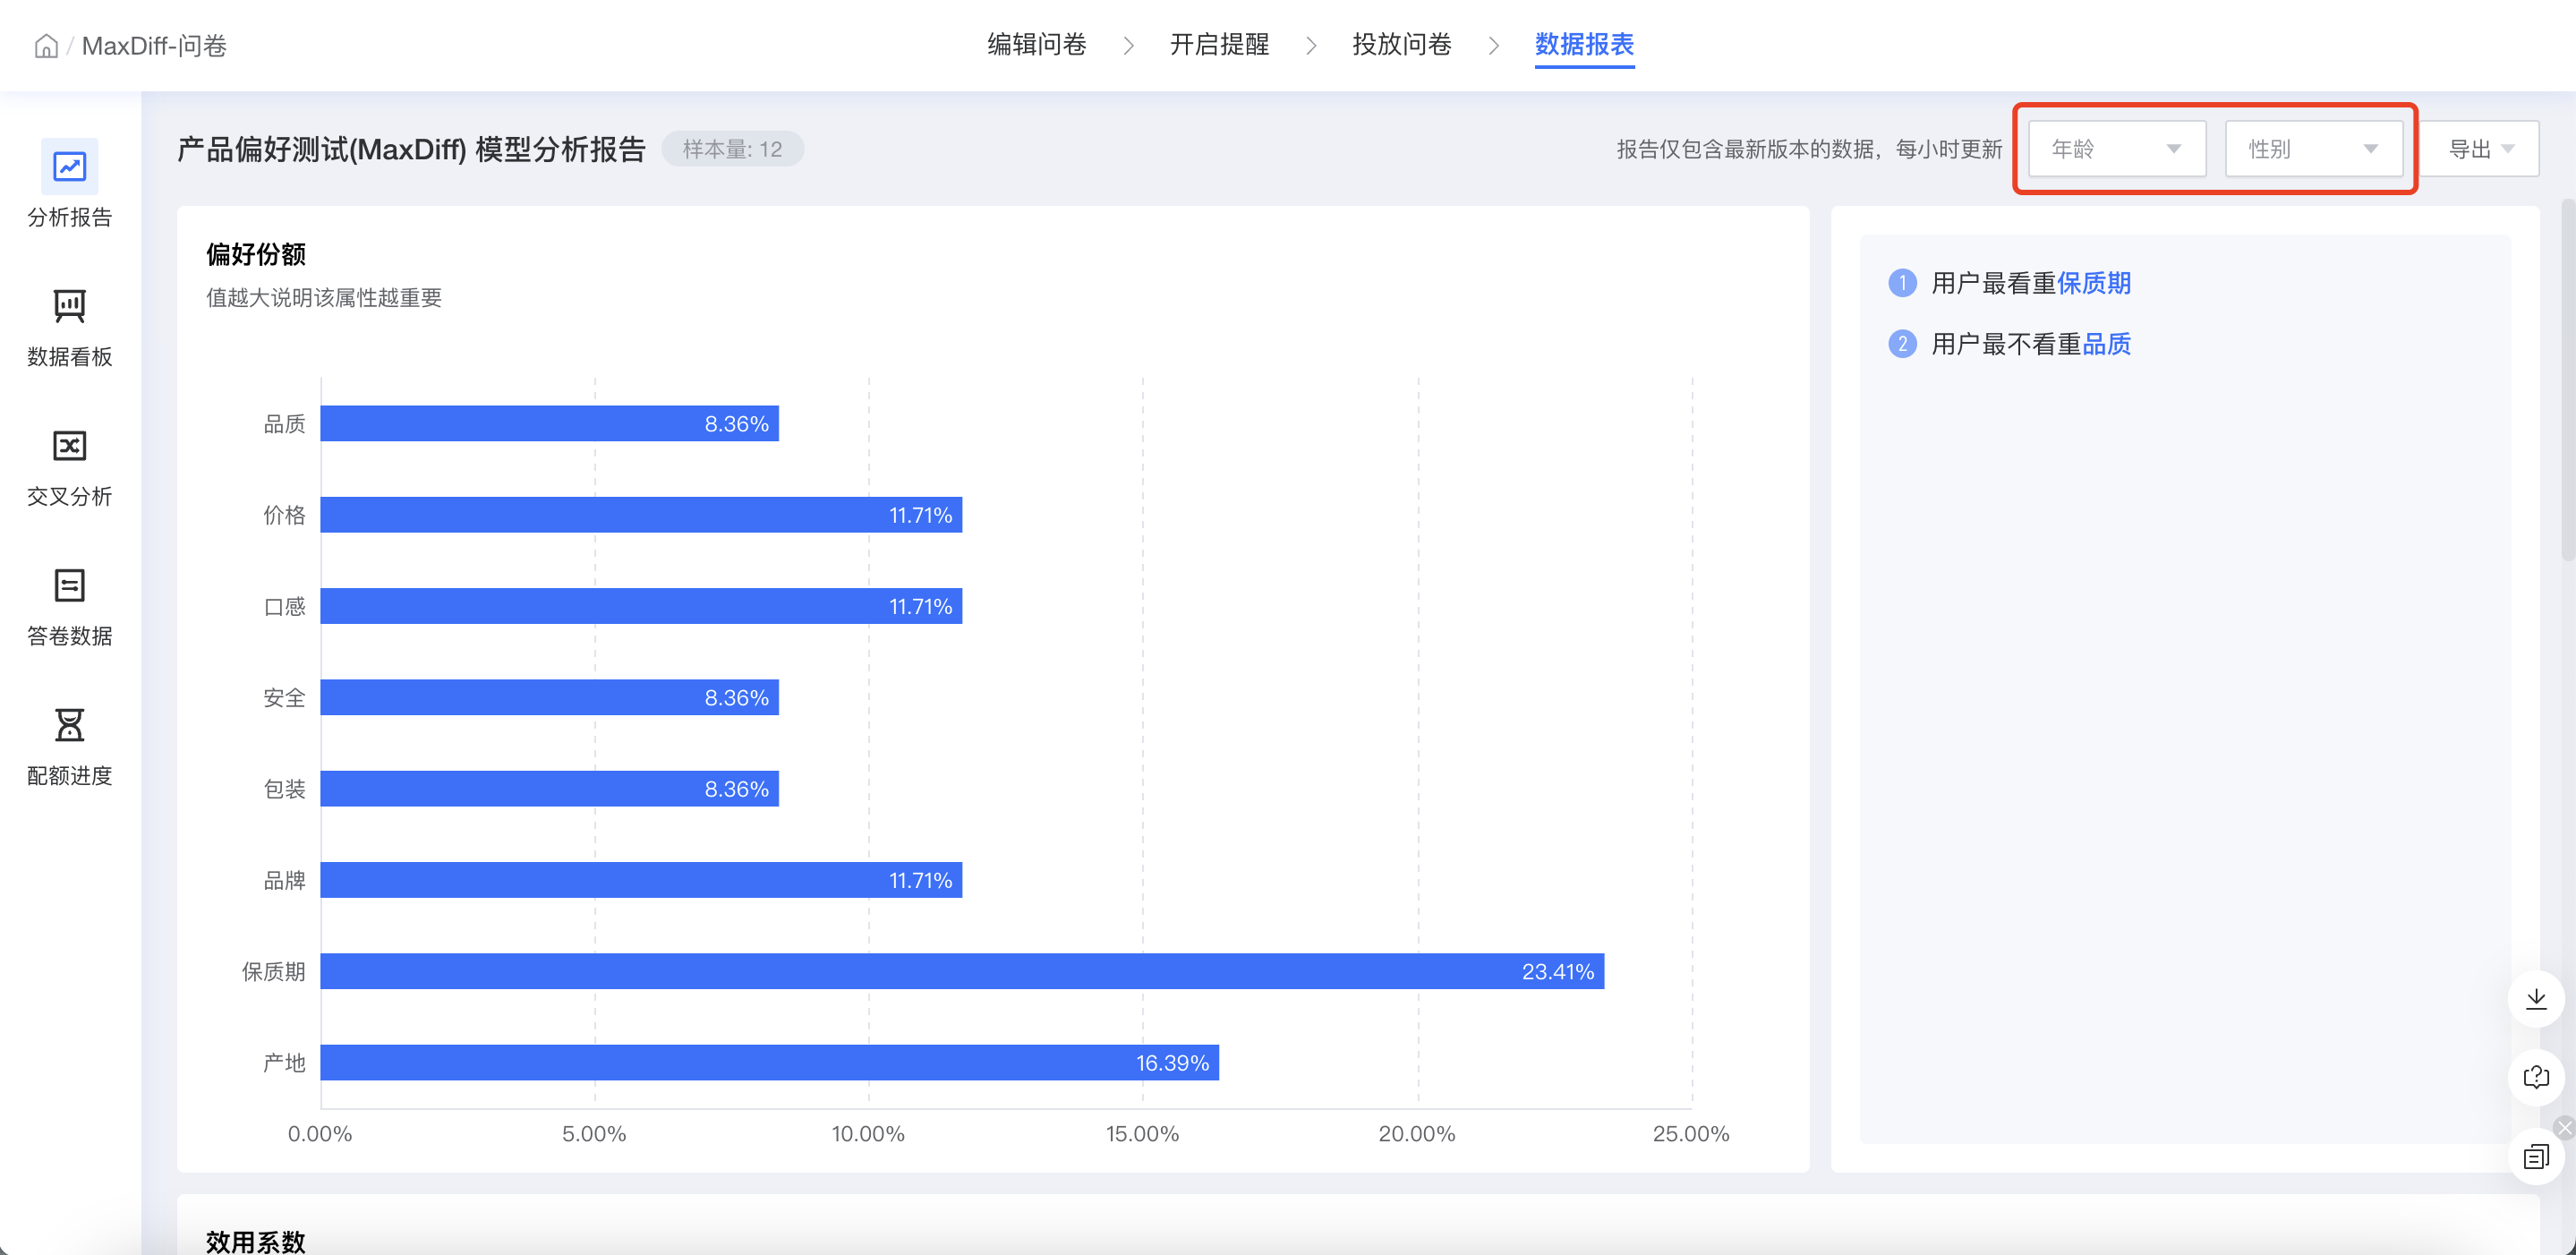
样本量即成功完成答卷数,或者上传文件的数据行数。
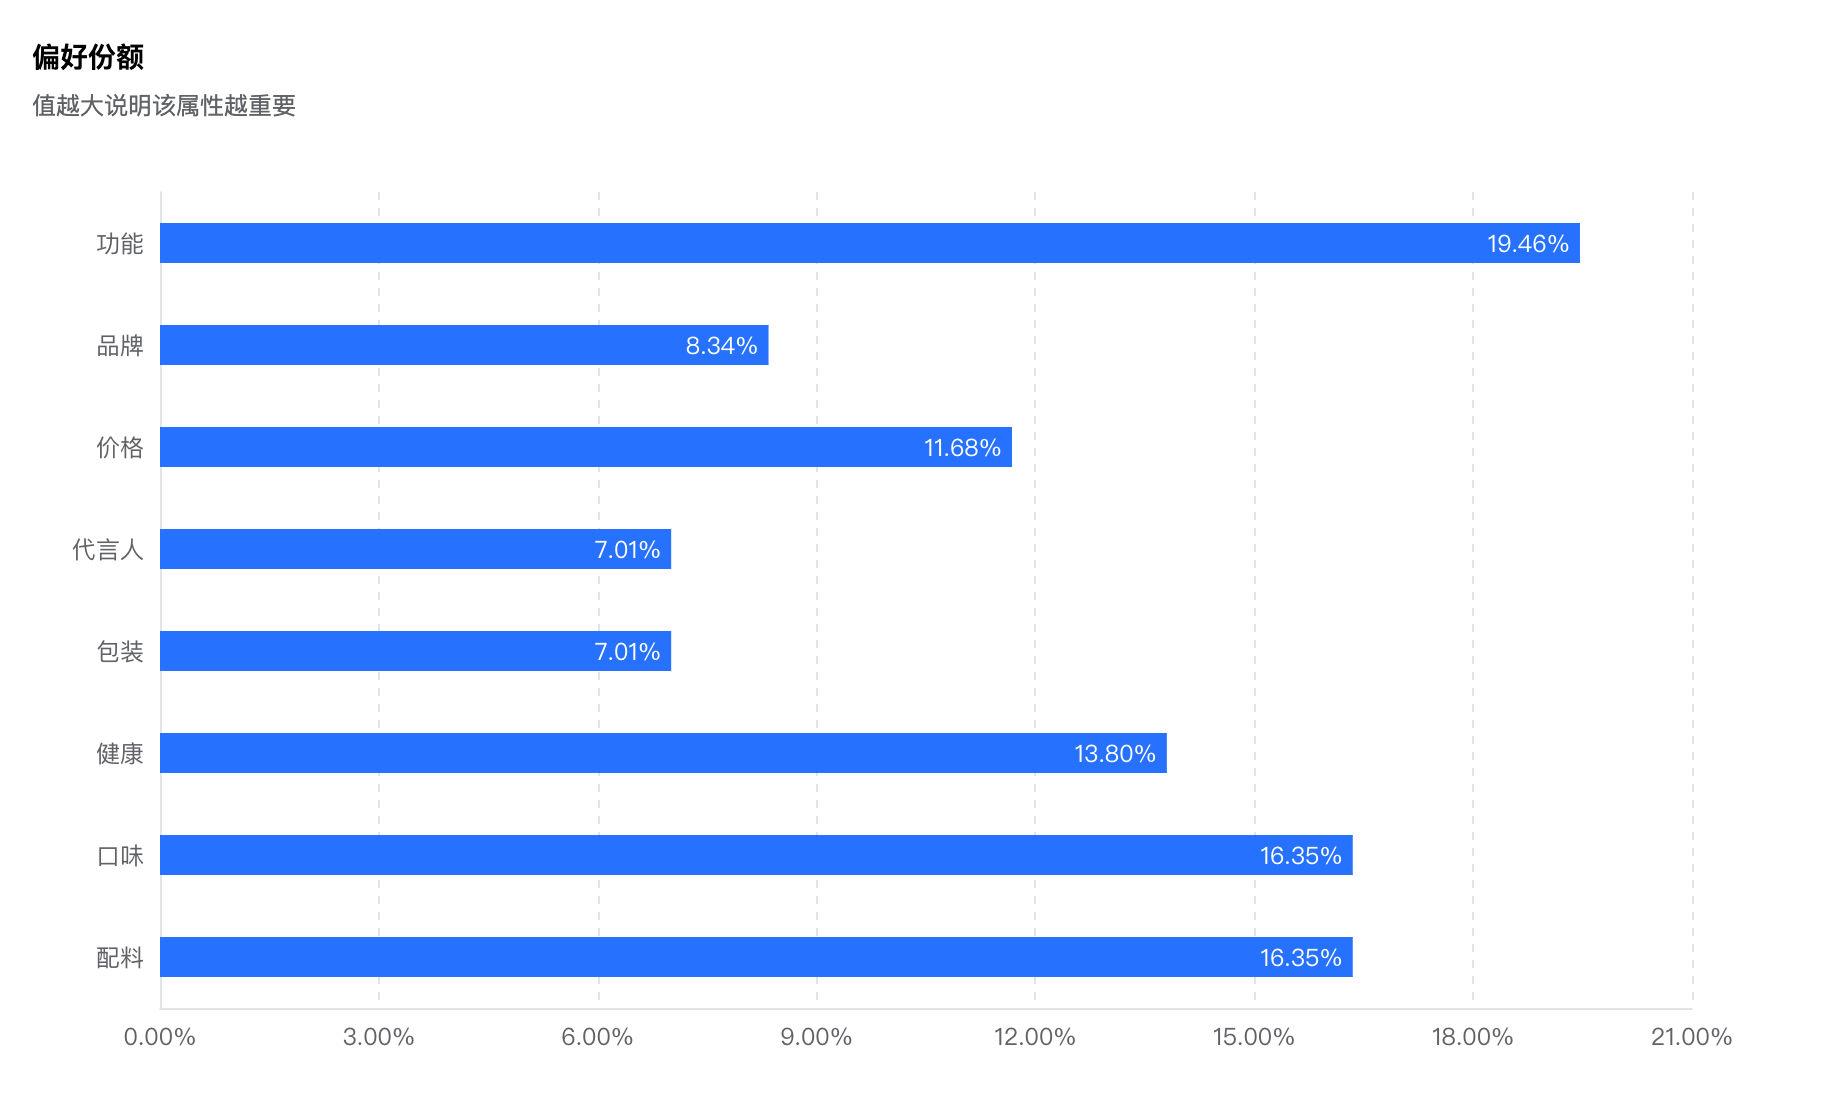
(2)偏好份额
直观地展示了各个属性的重要性程度,值越大说明该属性越重要。
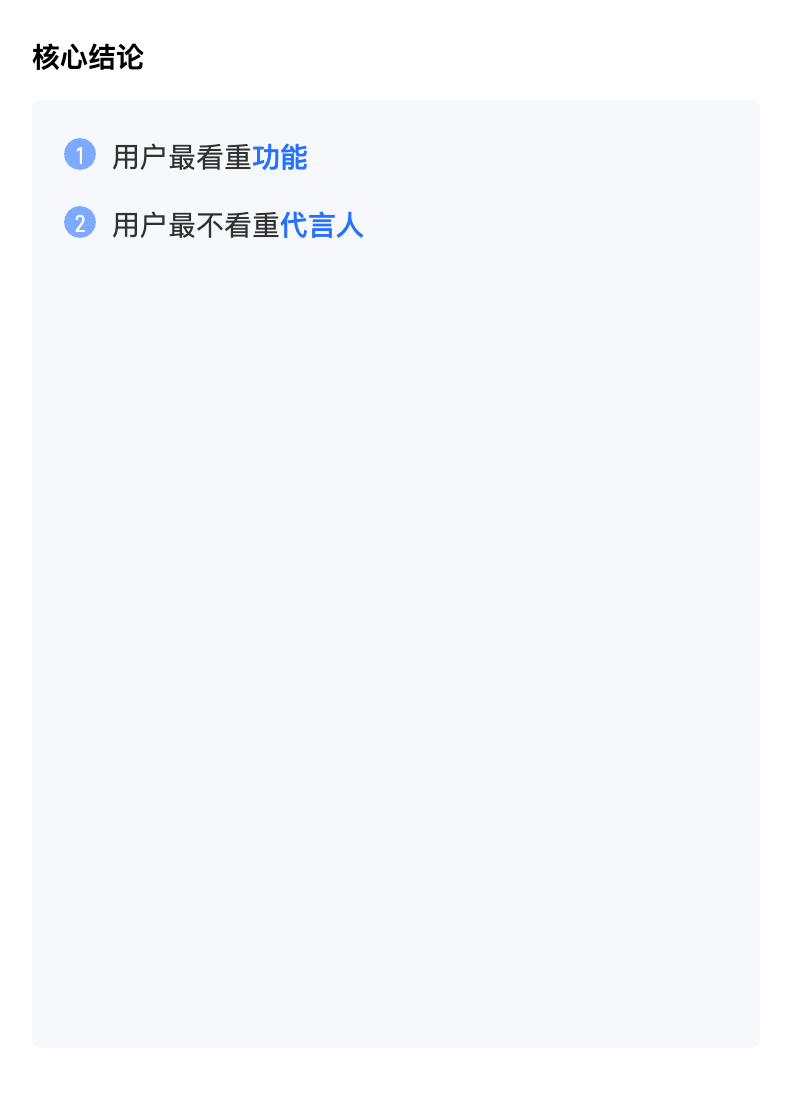
(3)核心结论
模型根据偏好份额自动生成核心结论,包括用户最看重和最不看重的属性。
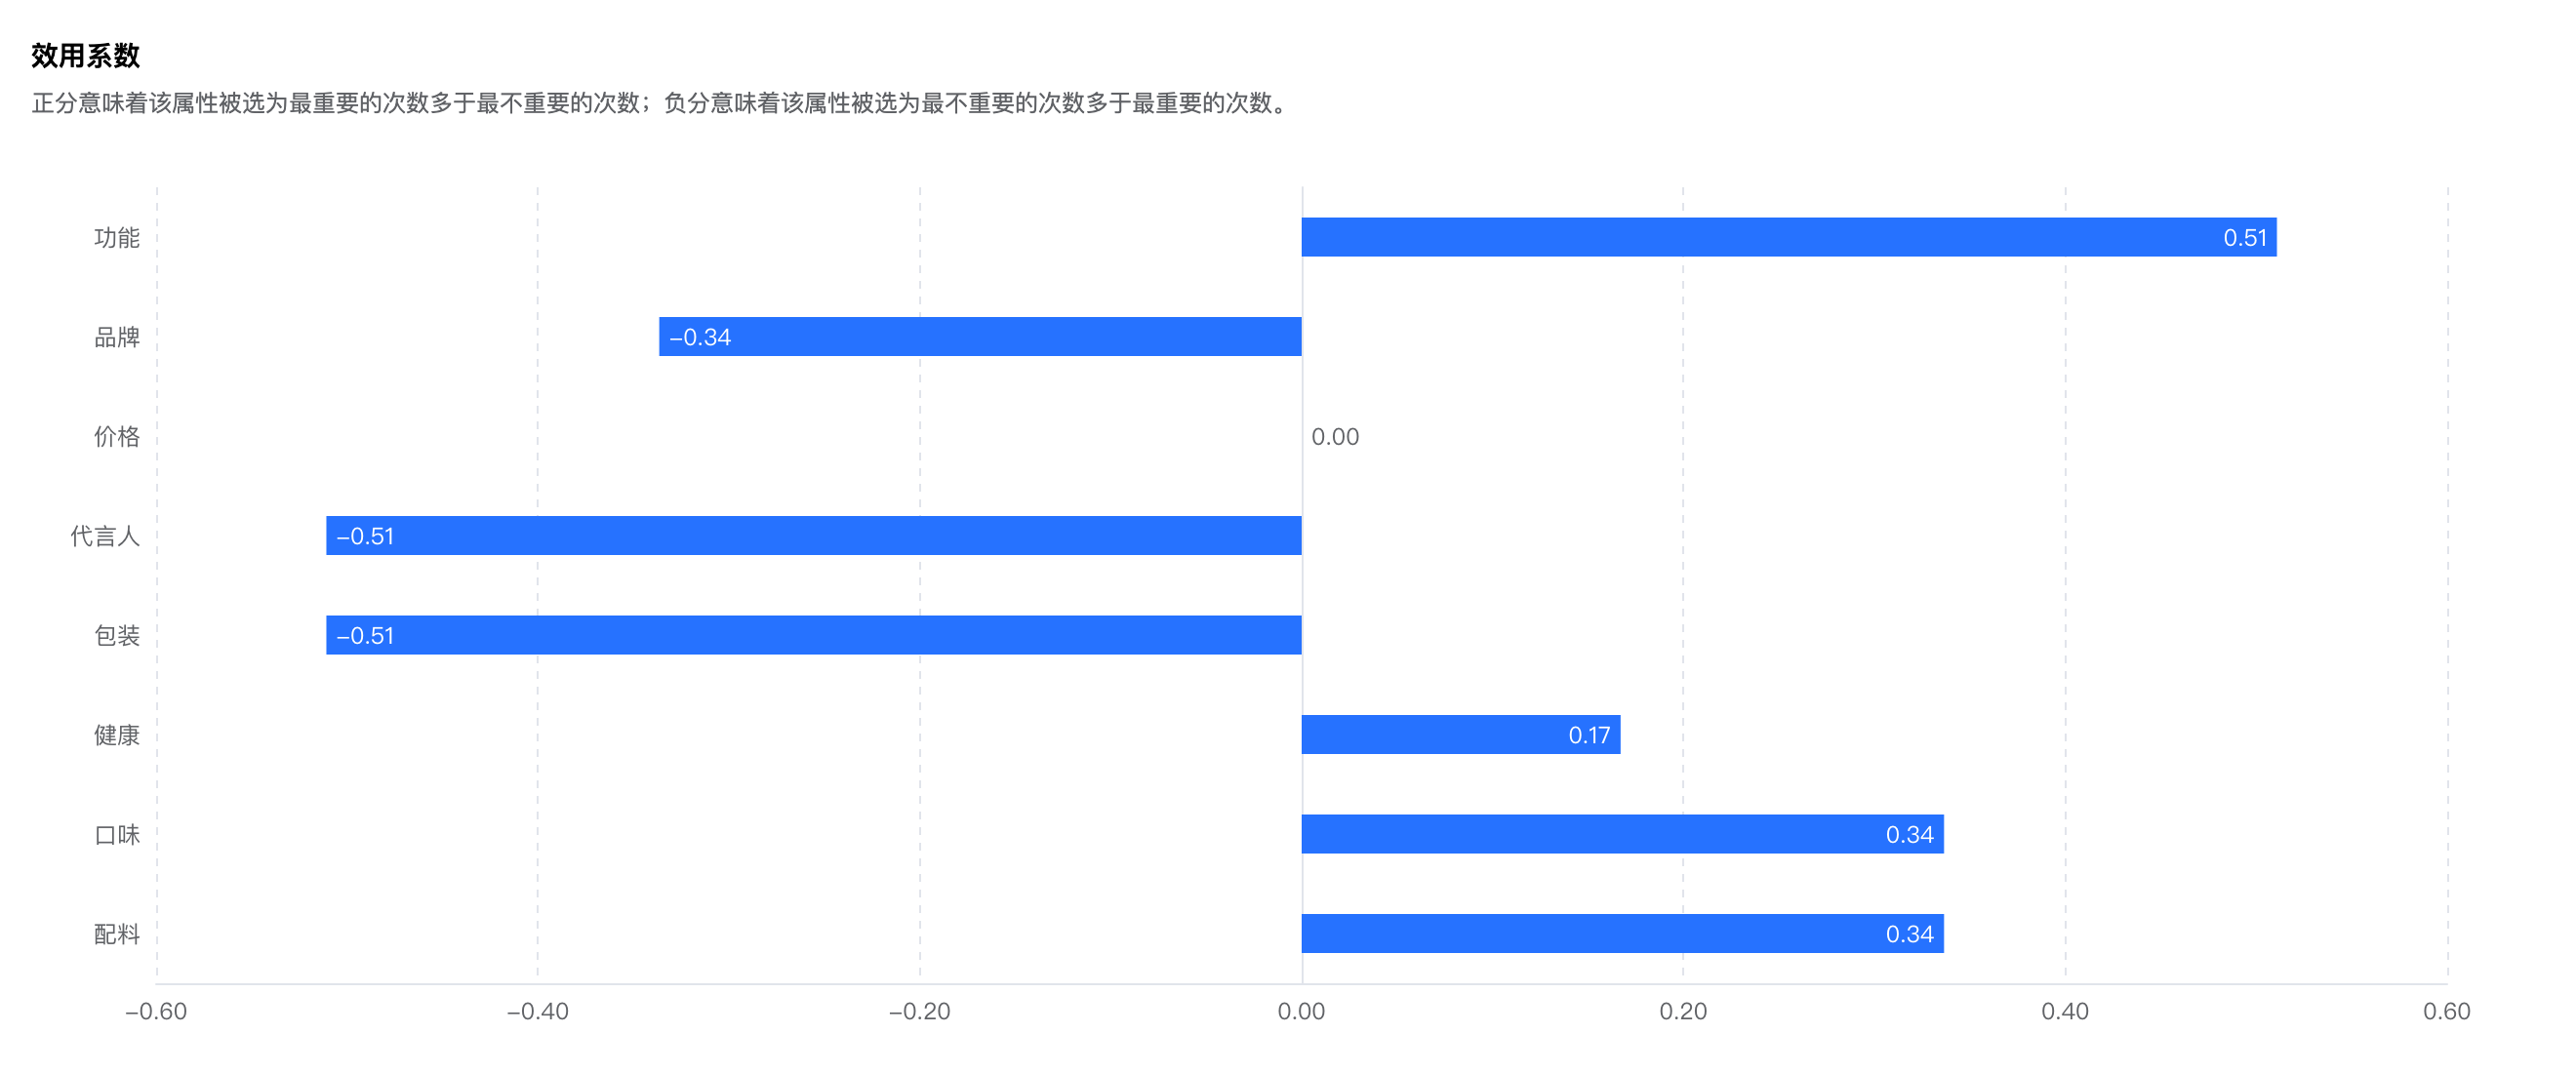
(4)效用系数
正分意味着该属性被选为最重要的次数多于最不重要的次数;负分意味着该属性被选为最不重要的次数多。
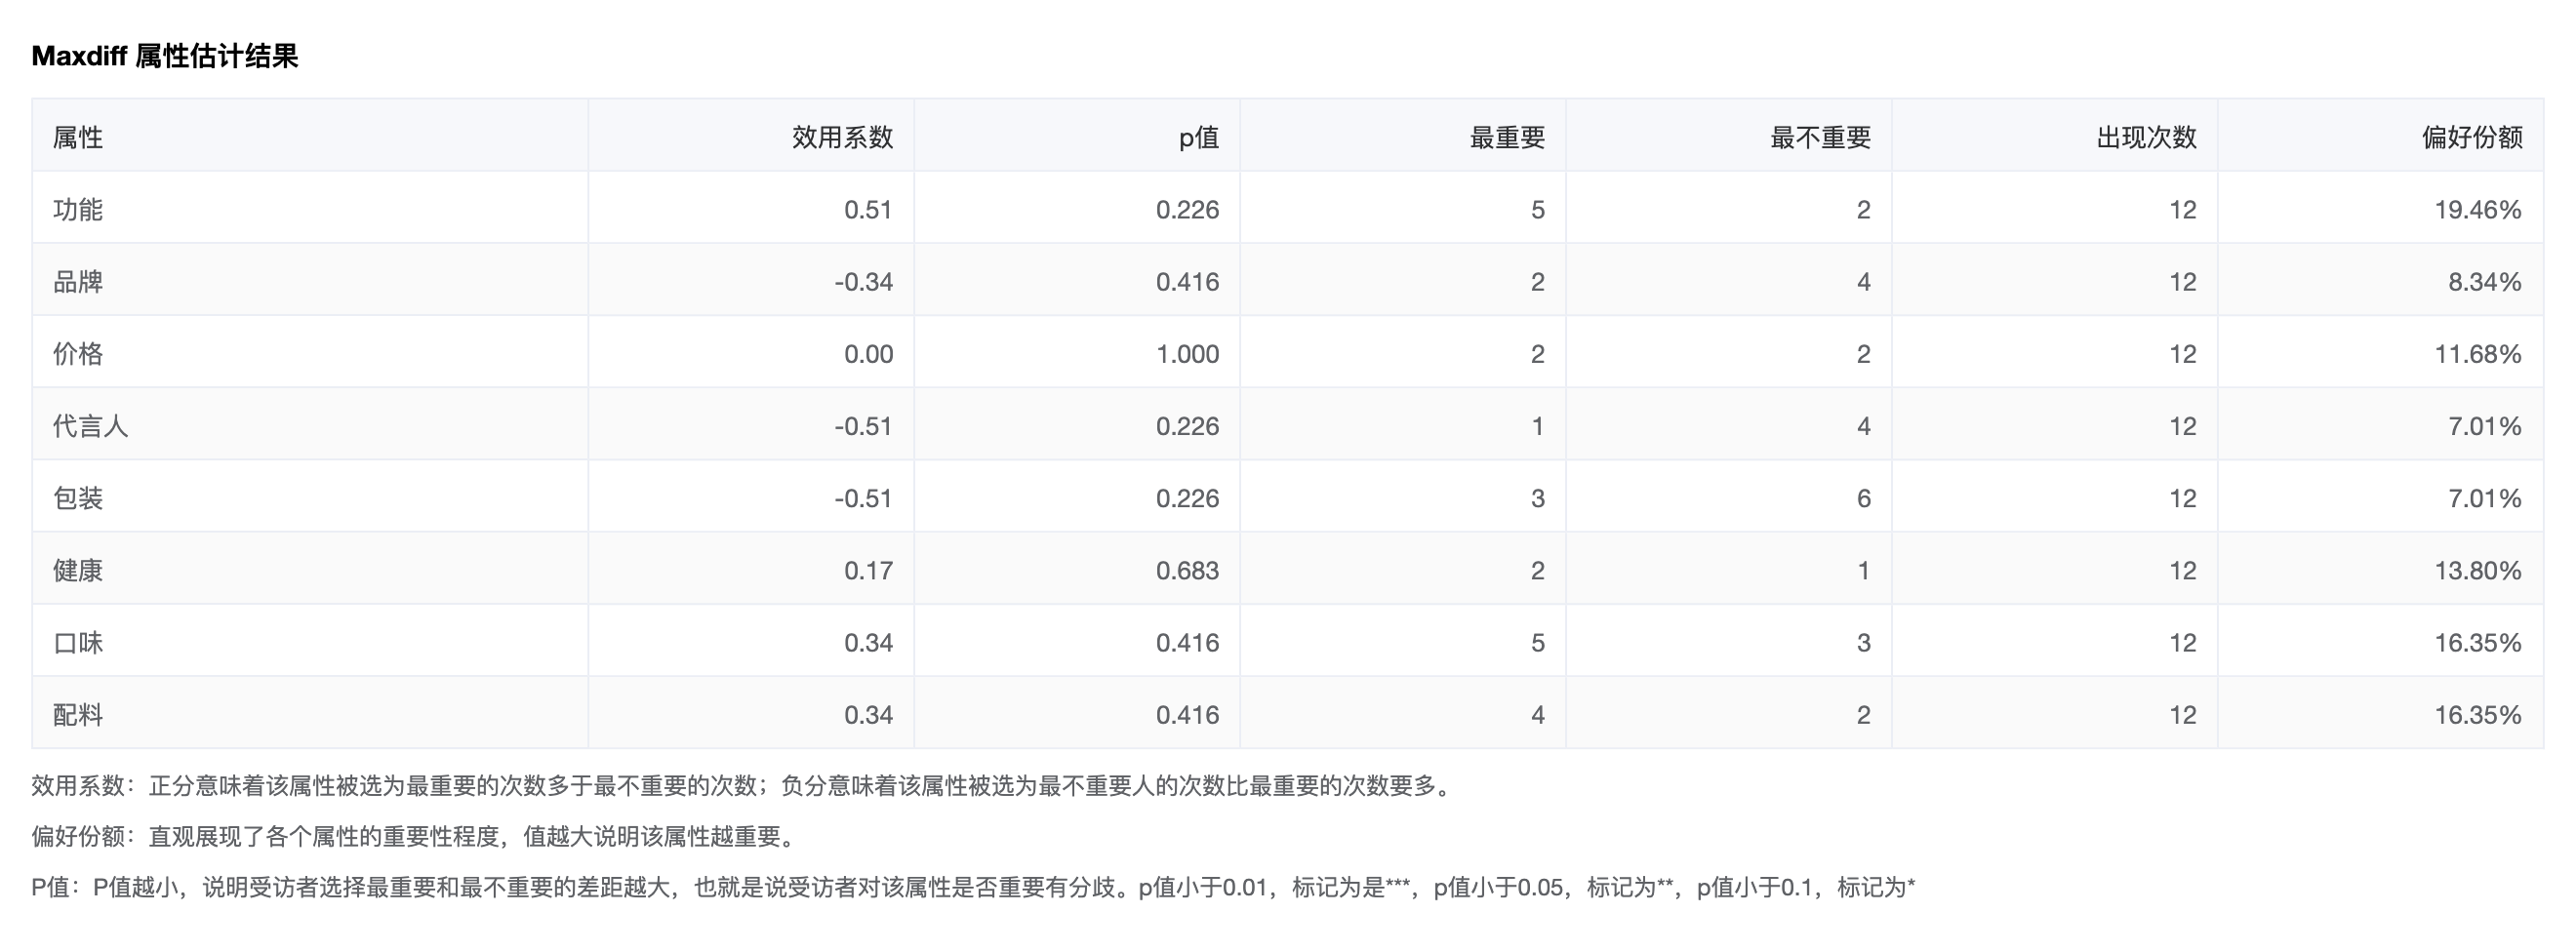
(5)MaxDiff属性估计结果
效用系数:正分意味着该属性被选为最重要的次数多于最不重要的次数;负分意味着该属性被选为最不重要人的次数比最重要的次数要多。
偏好份额:直观展现了各个属性的重要性程度,值越大说明该属性越重要。
P值:P值越小,说明受访者选择最重要和最不重要的差距越大,也就是说受访者对该属性是否重要有分歧。p值小于0.01,标记为是***,p值小于0.05,标记为**,p值小于0.1,标记为*