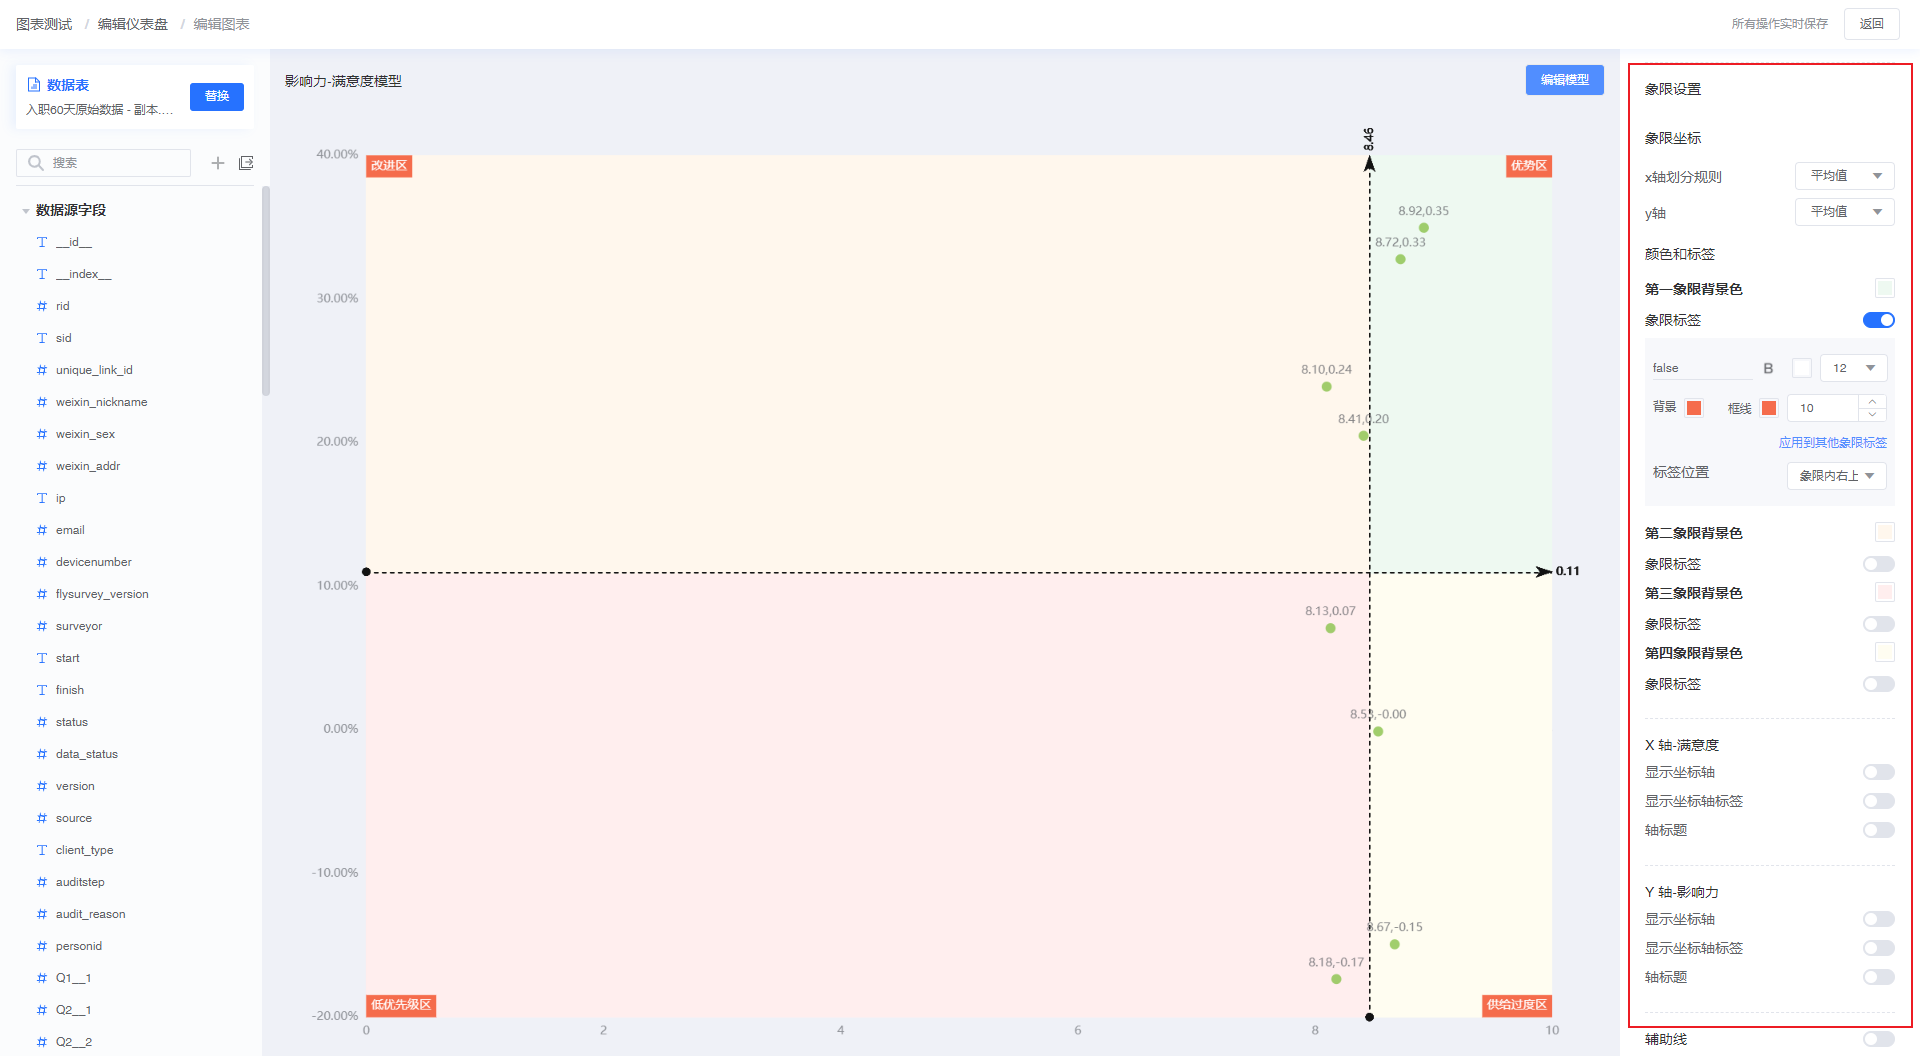
影响力-满意度分析模型
一、模型定义
1、模型意义
影响力-满意度分析,也被称为IPA(importance-performance analysis)。是一种常见的用户研究模型,研究的核心即围绕服务品质,对用户体验(某项 服务 / 功能 / 业务环节 )进行研究,将服务 / 功能 / 业务环节进行归类,分为四类,基于分类进行业务提升: ①优势区:说明是这些是优势项可以重点突出或保持。 ②改进区:顾客较重视,但实际的体验满意度不高,说明需要重点加强改善。 ③低优先级区:影响力及满意度都不高,即使投入精力提升该因素,满意度也不会有太大提升,这部分指标减少关注作为次重点改进。 ④供给过度区:满意度大于重要性,可以适当减少对这些指标的关注,保持现有水平即可。 模型可视化示例:
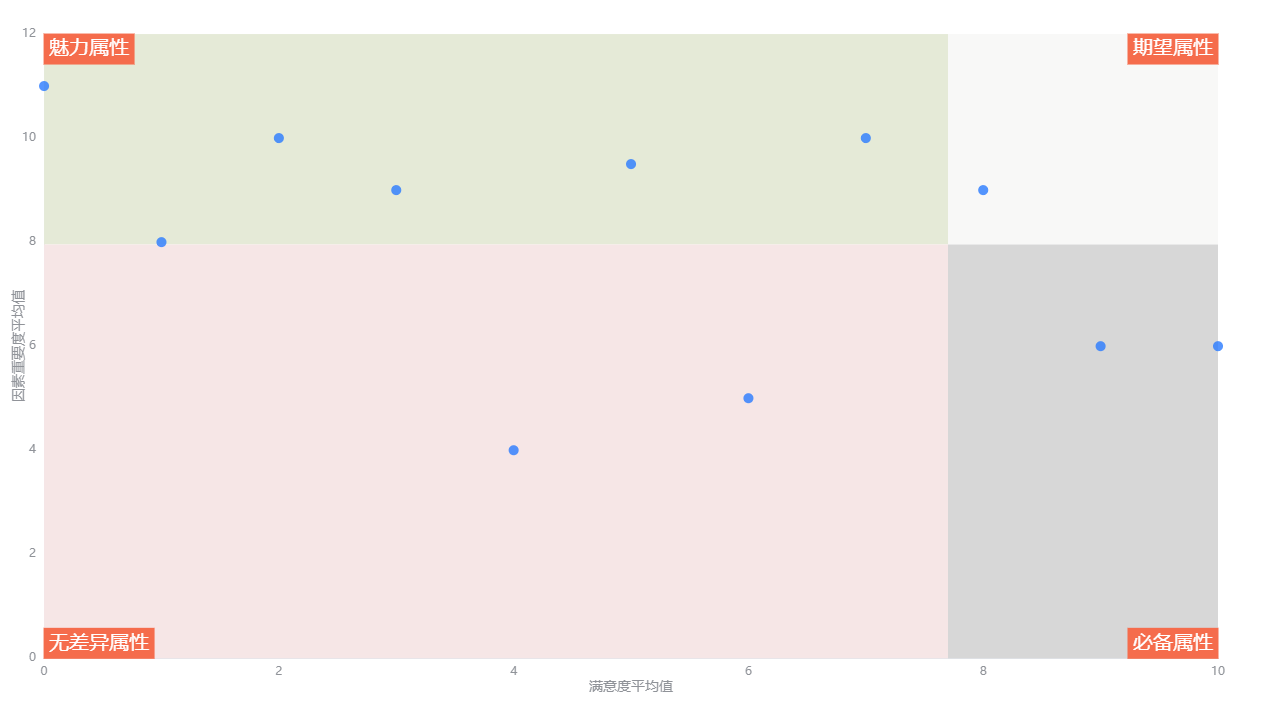
2、名词解释 【重要】有时候也会以“期望”、“影响力”、“重视”名词代表 【表现】常以“感受”、“满意”名词代表 在倍市得体系中,我们选取影响力和满意度两个名词分别指代。不论名词选取是什么,本质都是:使用对等的量表对同一个对象进行衡量。
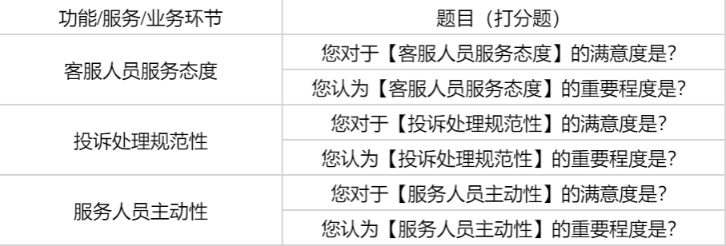
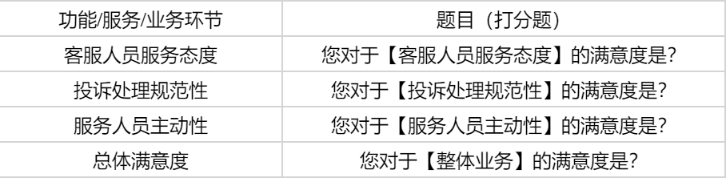
二、模型原理 1、 设置问卷 搜集受访者对于某项 服务 / 功能 / 业务环节 的重视程度和体验满意程度。针对不同结构的问卷,有对应的模型分析逻辑,因此基于问卷结构我们提供了两种模式的模型:①对称型结构 ②非对称型结构,使用模型前需要明确当前的问卷结构,由此来确定选择哪种模型。下面我们会举例来帮助理解两种模式:
(1) 对称型结构 在问卷题目上对每一个用户体验点,各自设置一道满意度题目&一道影响力题目,如下图示意:
(2) 非对称型结构 在问卷题目上对每一个用户体验点设置一道满意度题目 & 对整体满意度设置一道题目,如下图所示:
2、 模型数据处理 影响力满意度分析模型针对两种问卷结构也分别配备了两种模式的模型,两种模式分别支持不同的计算逻辑,下面分别来介绍:
(1) 对称型结构 对称型结构支持对影响力字段和满意度字段设置聚合方式如下:平均值(默认)、最大值、最小值、计数、去重计数、中位数、求和。 常规的对称型结构均以平均值为聚合方式进行计算。
(2) 非对称型结构 非对称型结构支持对影响力字段设置的聚合方式为:回归系数、标准回归系数(默认)、相关系数。对满意度字段设置的聚合方式为:平均值(默认)、最大值、最小值、计数、去重计数、中位数、求和、NPS指数。 常规的非对称型结构影响力聚合方式一般为:平均值、NPS指数;满意度聚合方式一般为:标准回归系数、相关系数。 注:NPS指数=非常满意者(≥9分)百分比 - 不满意者(≤6分)百分比
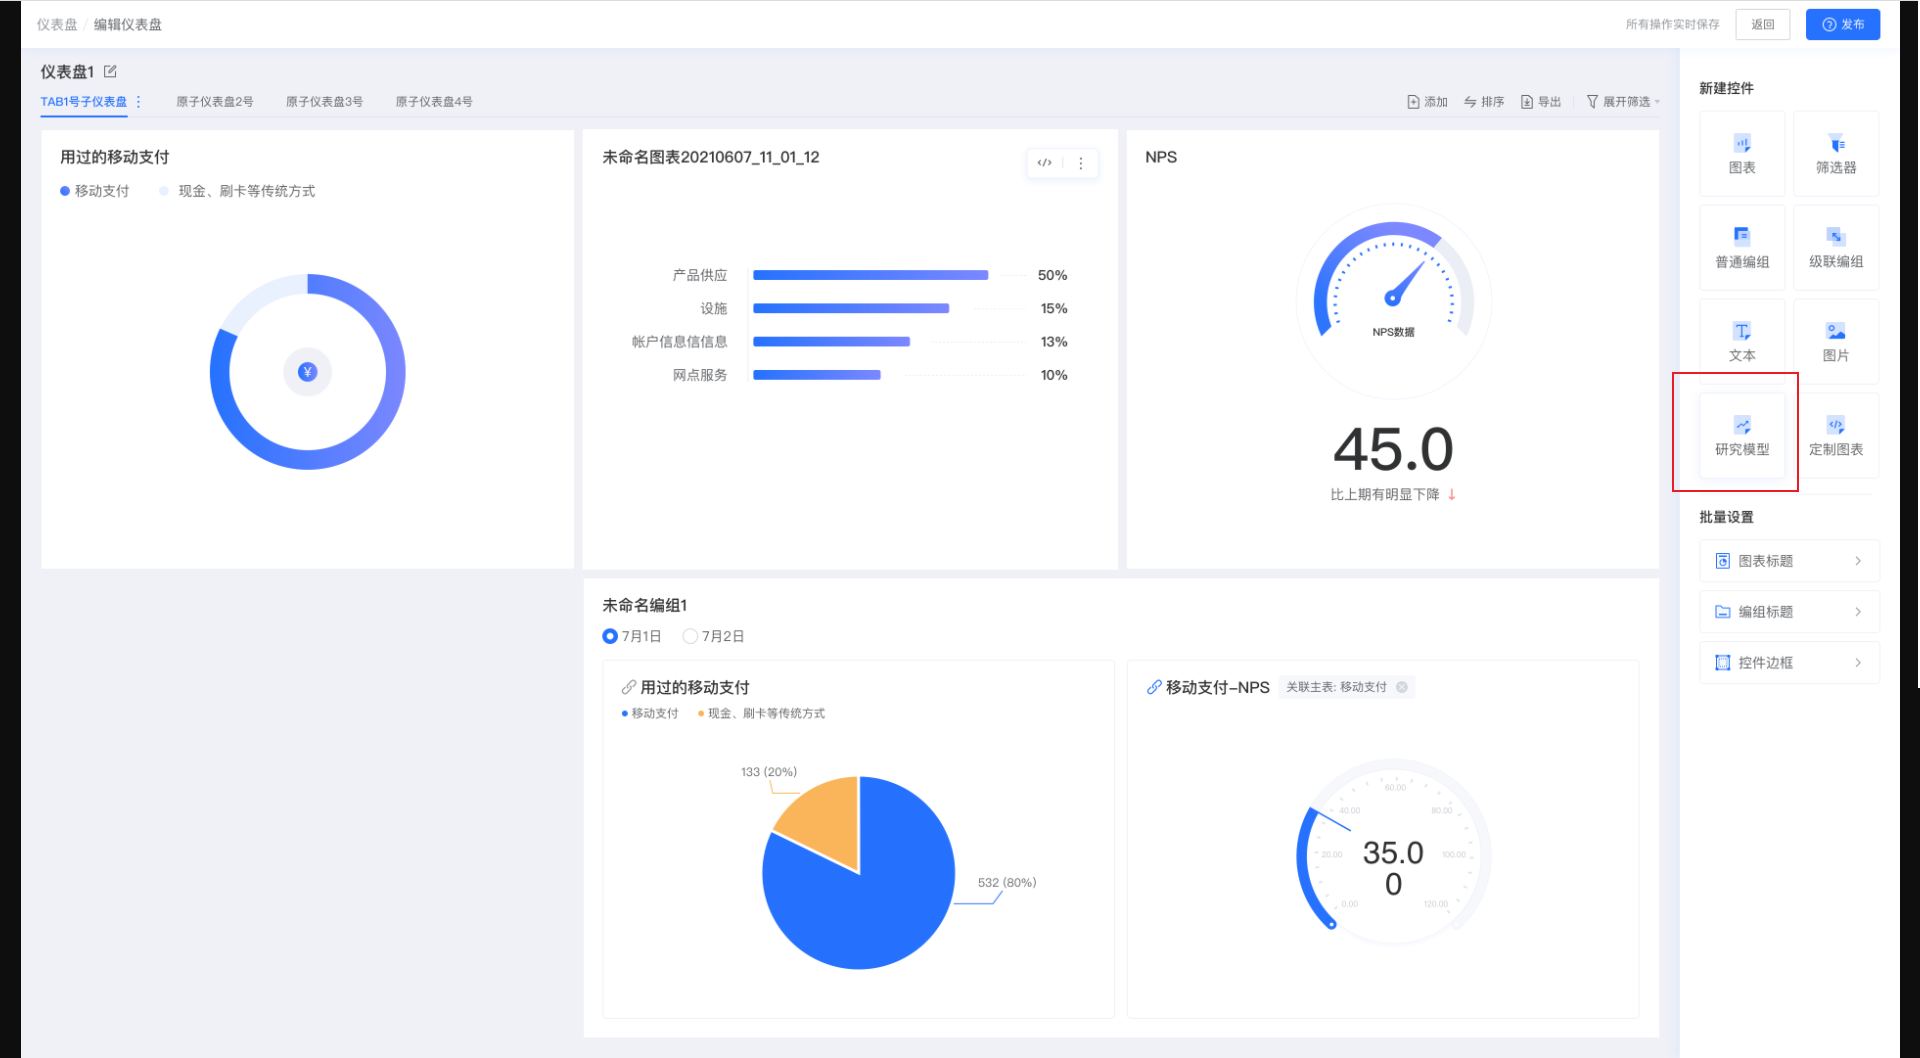
三、模型操作指南 1、 创建模型 第一步:点击仪表盘编辑页面的【研究模型】按钮。
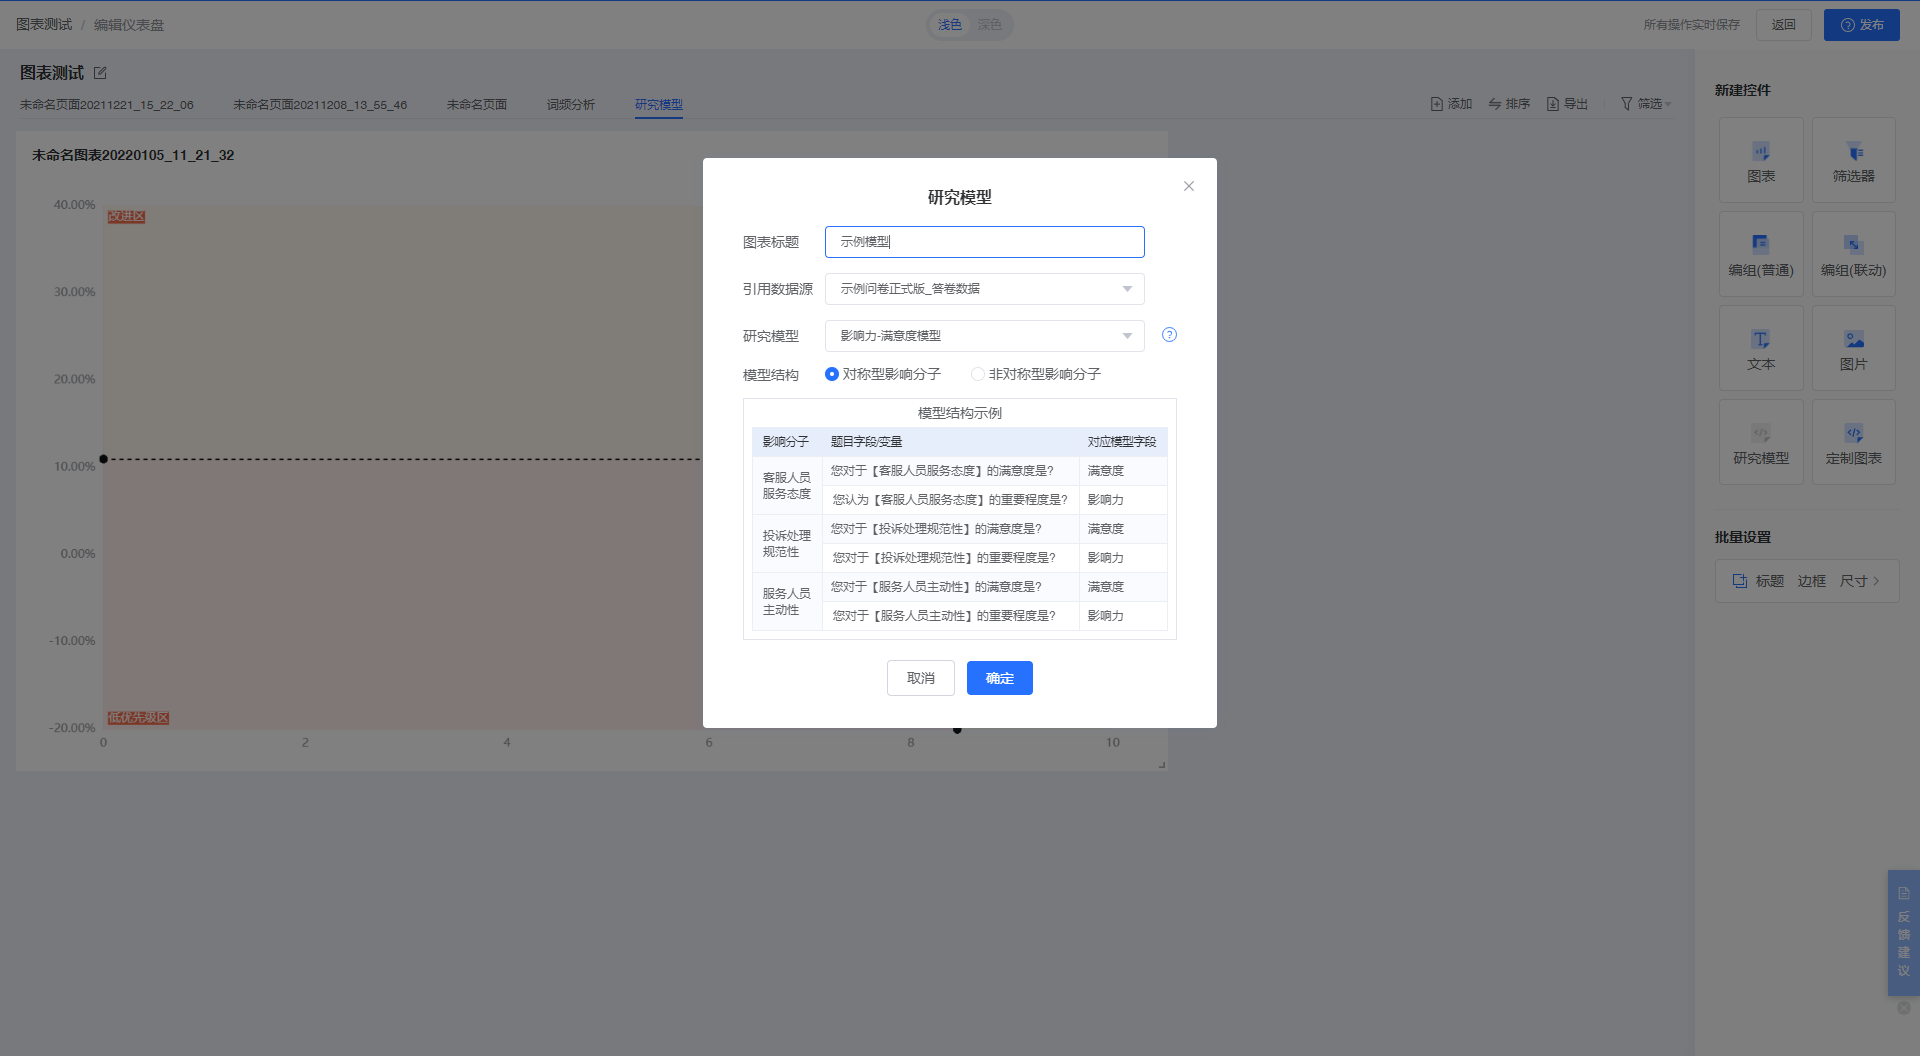
第二步:在创建研究模型弹窗中进行名称编辑、数据源引用、模型类型选择及模型结构选择。
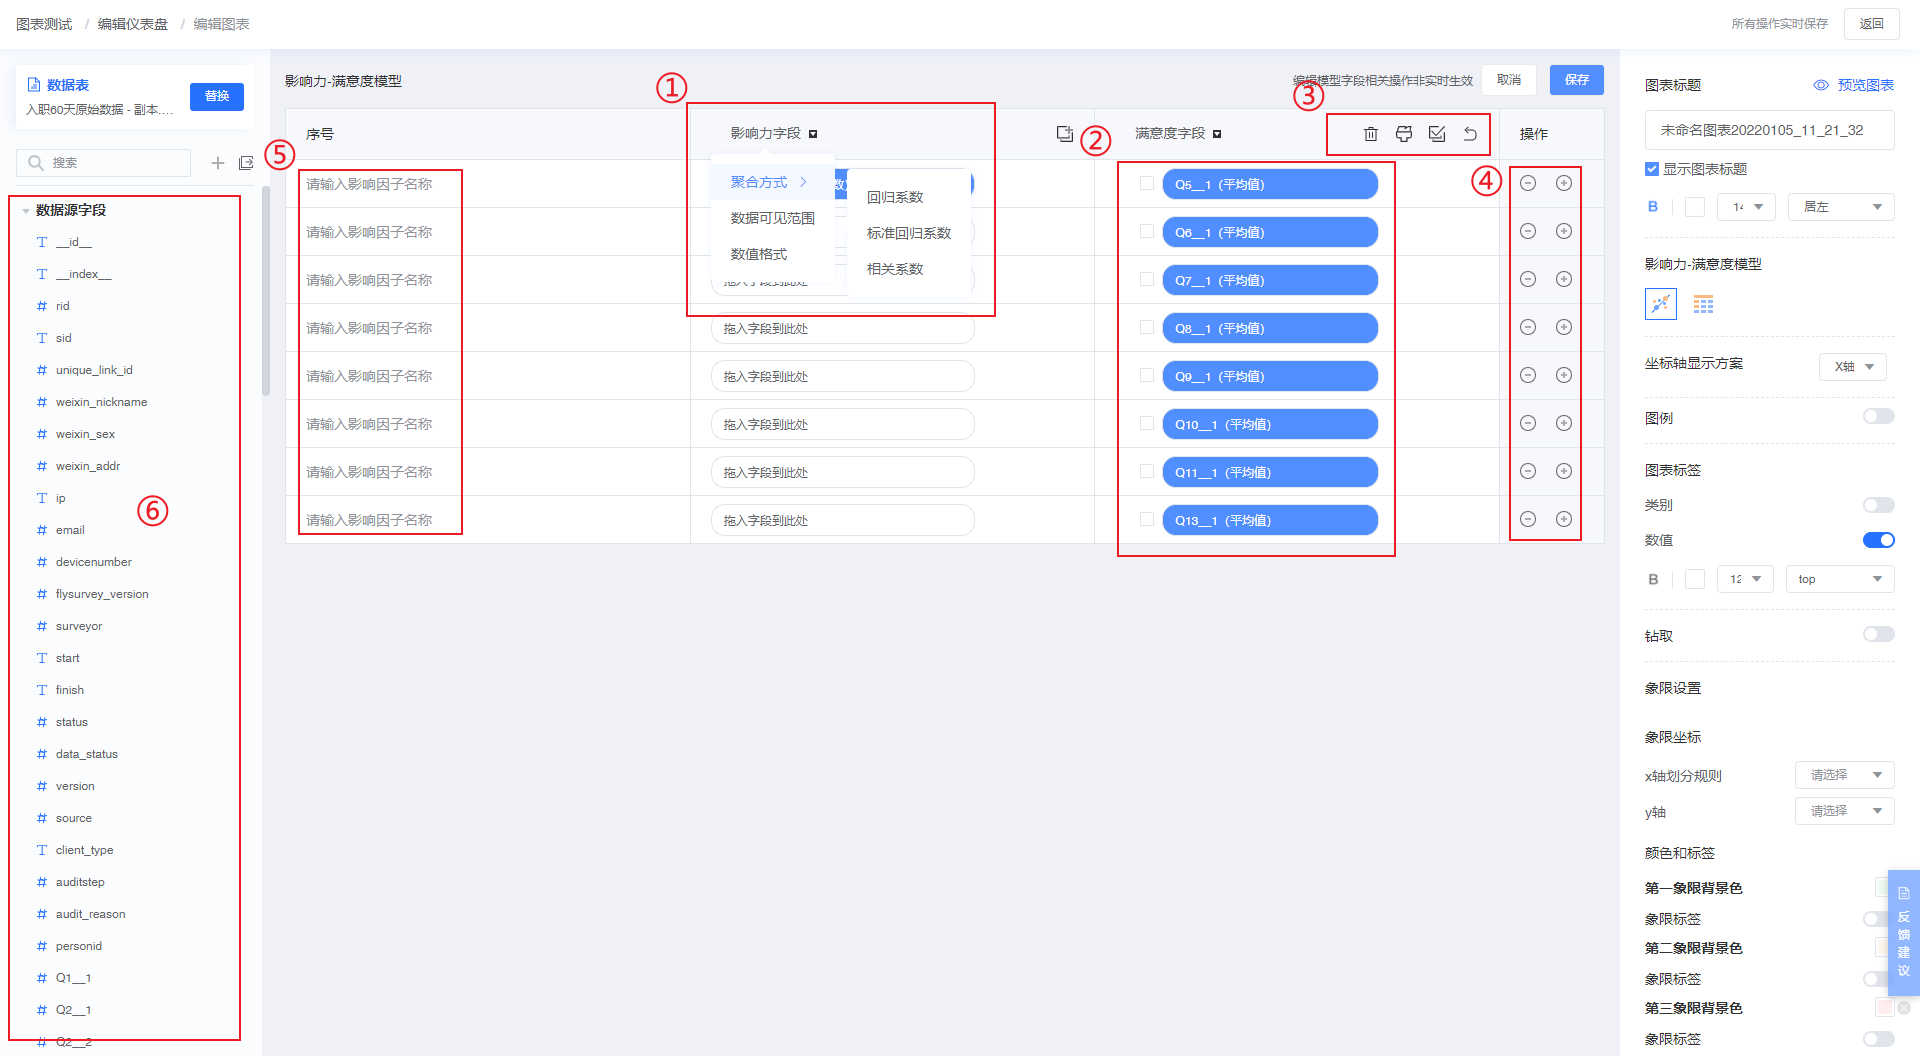
2、 编辑模型 在创建研究模型弹窗中点击确定后,进入如下图所示的模型编辑及配图页面: ①通过下拉框对影响力字段和满意度字段分别设置聚合条件。 ②通过拖拽⑥中的字段至②处实现模型构建。 ③通过批量操作模式,进行多字段拖入、多字段清除等操作。 ④通过操作列的加减按钮增加和删除字段组合。 ⑤支持针对每个体验点编辑输入影响因子名称。
3、 图表调整 通过右侧图表样式配置项来调整模型的可视化输出