体验双向归因模型
体验双向归因模型的作用
体验双向归因模型综合考虑品牌与用户之间的相互作用,在满意度/NPS推荐意愿场景下,确定需要重点保持和优先改进的产品功能或服务。
问卷设计
体验双向归因模型的问卷由四部分组成:分组、NPS、推荐原因、不推荐原因。
(1)分组
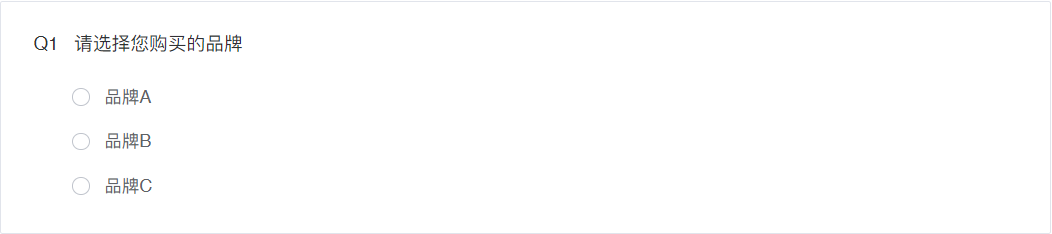
分组常在市场细分时使用,比如按城市或者按不同的业务线。假设客户品牌有三条业务线,分组可以这样设计:
(2)NPS
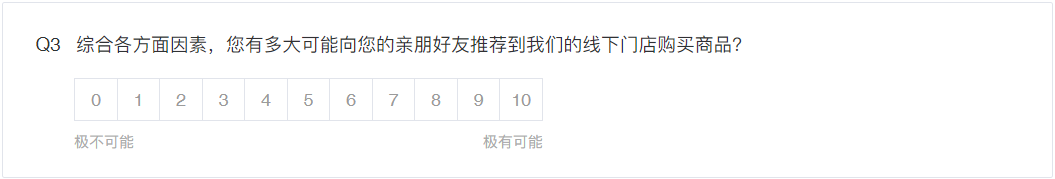
当用户打分大于等于9分时,跳转到推荐原因。反之,跳转到不推荐原因。
(3)推荐原因和不推荐原因
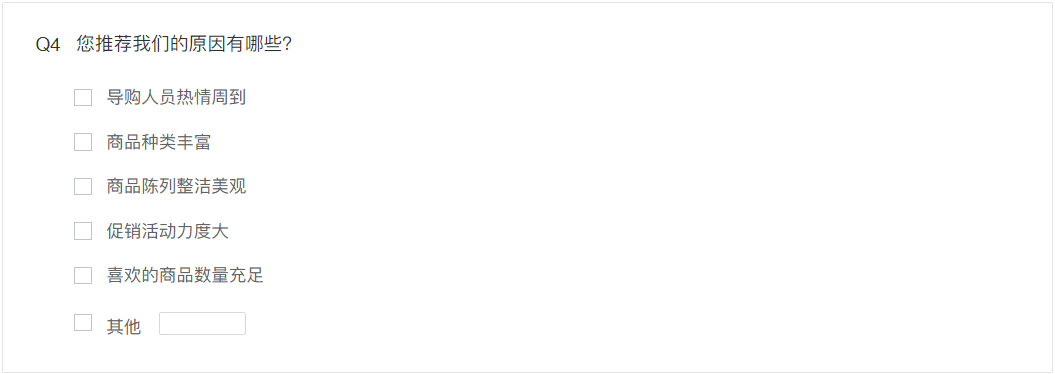
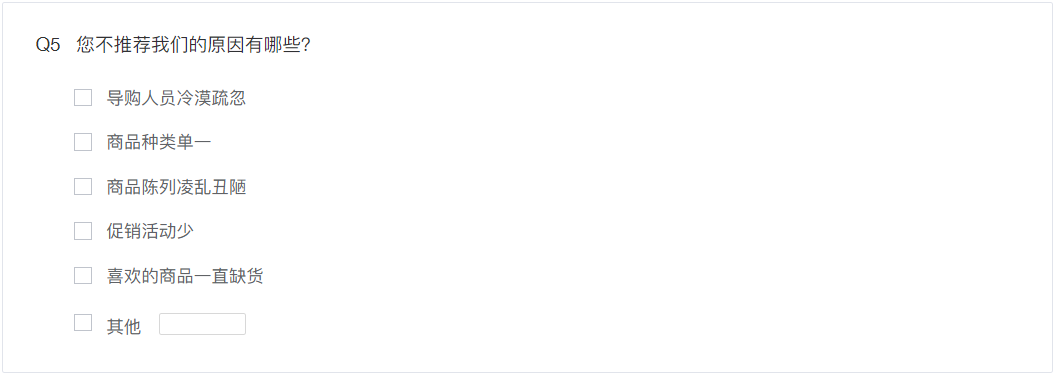
推荐原因和不推荐原因的选项内容根据客户需要配置。需要注意的是,选项内容和顺序需要严格对应。以下图为例,推荐原因的选项1是“导购人员热情周到”,那么不推荐原因的选项1就是“导购人员冷漠疏忽”。这两个选项构成一组对导购人员态度的描述。
(4)注意事项
为保证正常生成分析包括,请按照以下说明操作,并注意系统的提示信息:
- “分组”常在市场细分时使用,比如按城市或者按不同的业务线,通常默认为问卷第一题。如果设置了分组,模型会对每组单独进行双向归因分析。如果不需要可以将分组题删除。
- “正向题”即推荐理由,“负向题”即不推荐理由。放置在“正向题”题目组中的题目模型将判定为正向题,同理,放置在“负向题”题目组中的题目系统将判定为负向题。如果您需要新增题目,建议新增题目组并将新题目放置在新题目组中。
- 正向题和负向题的选项顺序需要严格对应。例如,推荐原因的选项1是“促销活动力度大”,那么不推荐原因的选项1应该是“很少有促销活动”。模型并会根据选项顺序对原因进行分组,在最终报告上取正向题的表达展示原因。在上述例子中,您在图表上会看到“促销活动力度大”的要素重要性和NPS值。
- 请保证对应选项拥有相同的选项编号。例如,推荐原因的选项1“促销活动力度大”的选项编号是1。那么,不推荐原因的选项1“很少有促销活动”的选项编号也应该是1。请确保“并没有什么特别原因”的选项编号是98,“其他”的选项编号是99。
- 请不要删除“并没有什么特别原因“或”其他“选项。
- 除分组题,请不要删除其他预置的题目或题目组,不要调整显示逻辑。
数据结构
系统将答卷数据解析为如下数据结构。0代表未选择,1代表已选择。

分析报告
(1)样本量
样本量即成功完成答卷数,或者上传文件的数据行数。
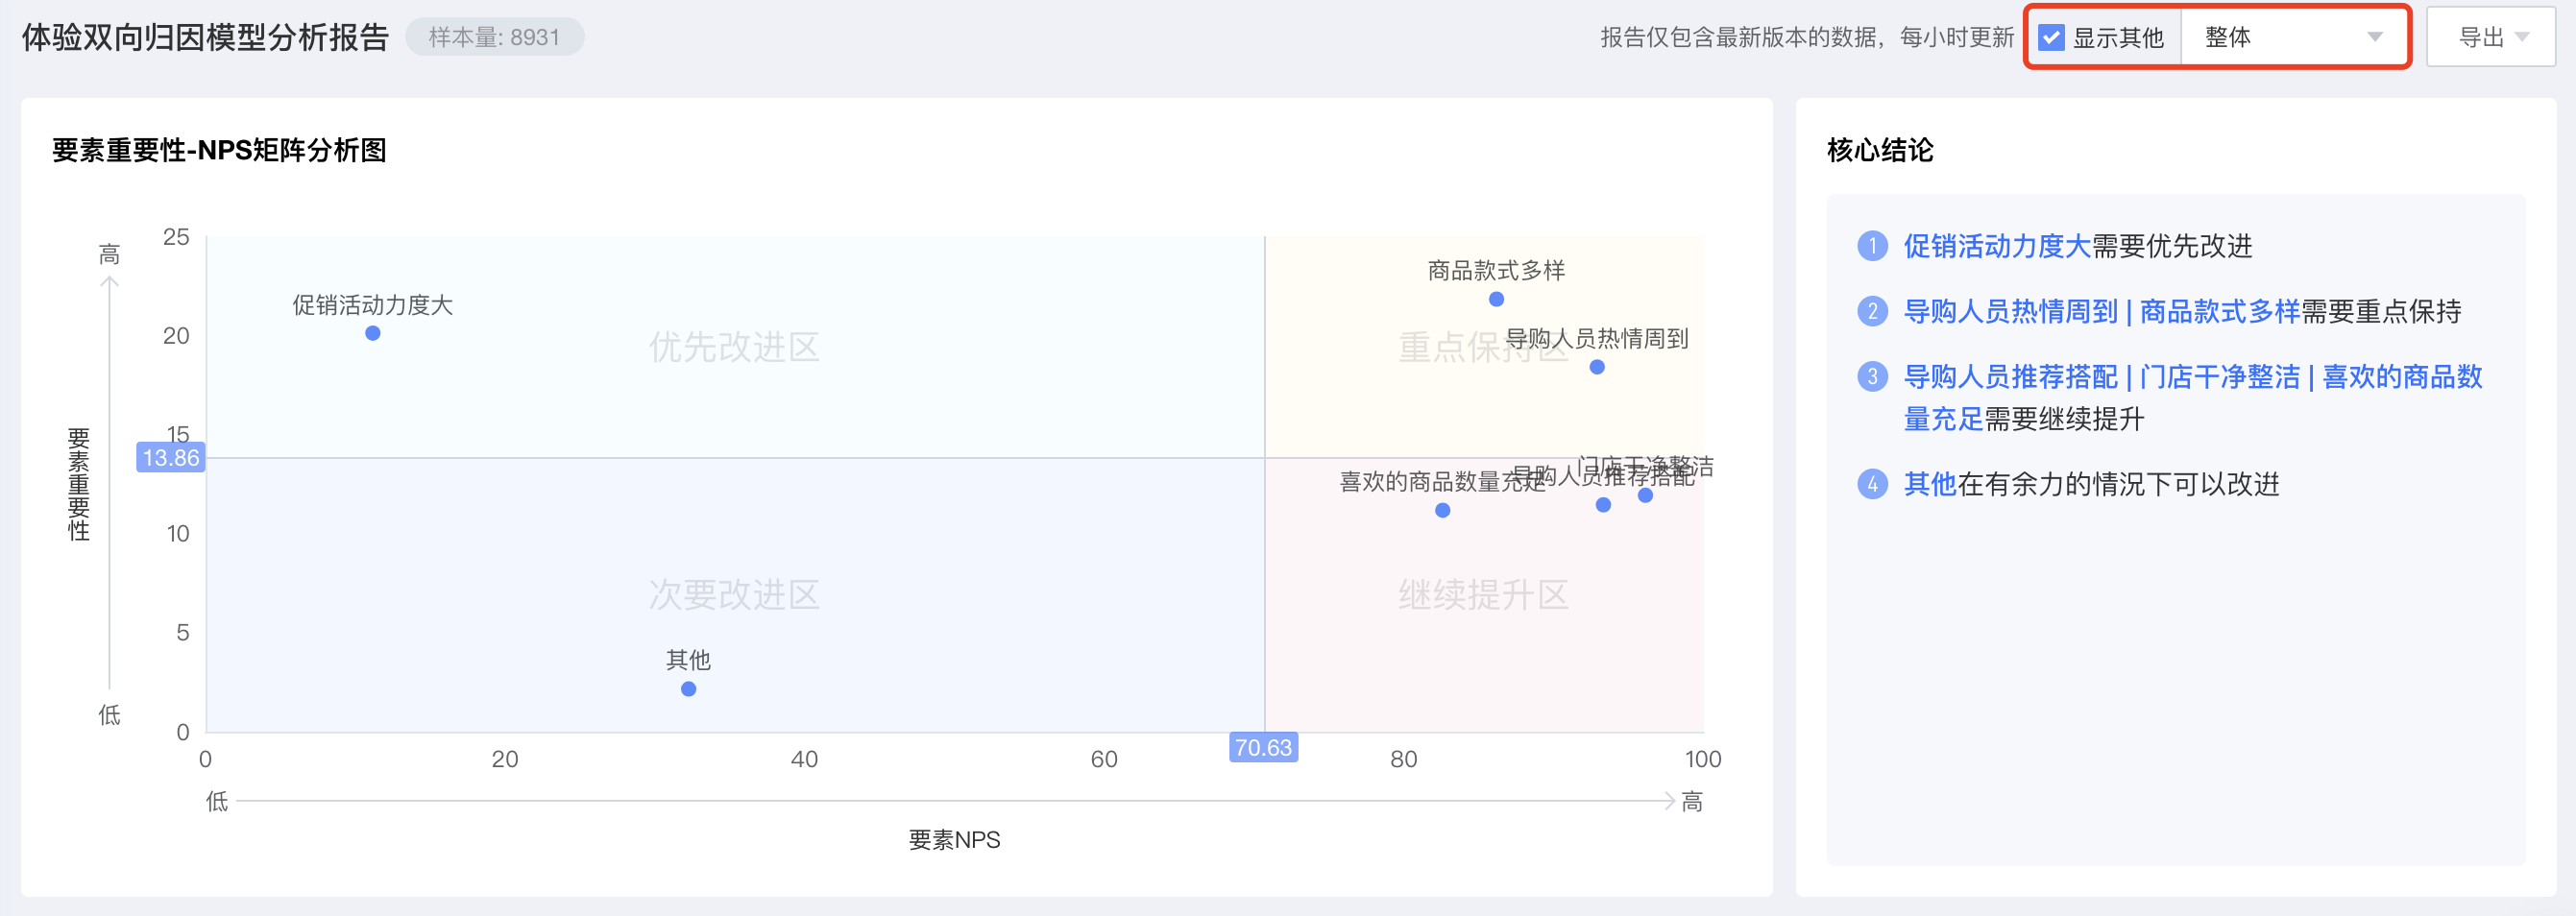
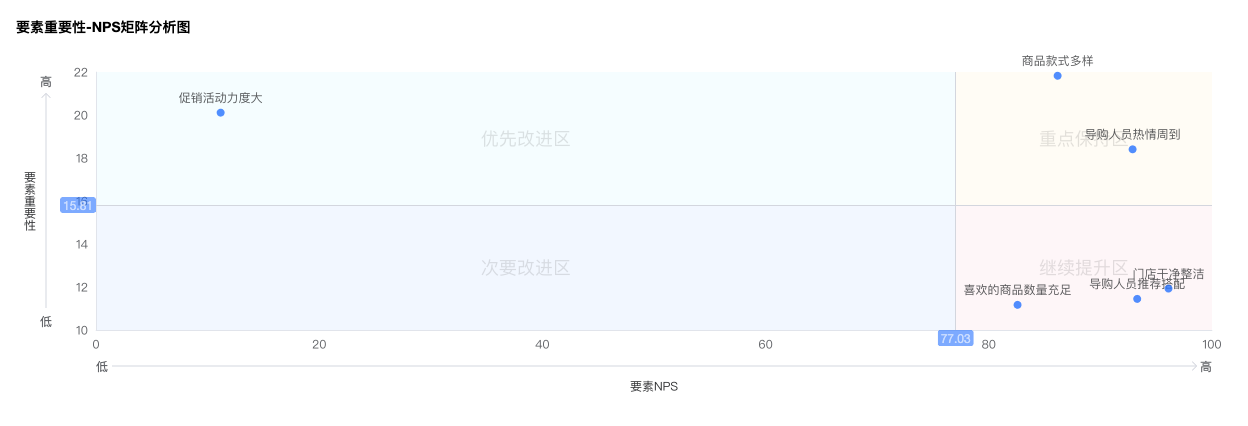
(2)要素重要性-NPS矩阵分析图
根据要素NPS和要素重要性,将散点图划分为四个象限:
优先改进区(左上象限):重要性高、NPS低
重点保持区(右上象限):重要性高、NPS高
次要改进区(左下象限):重要性低、NPS低
继续提升区(右下象限):重要性低、NPS高
(3)核心结论
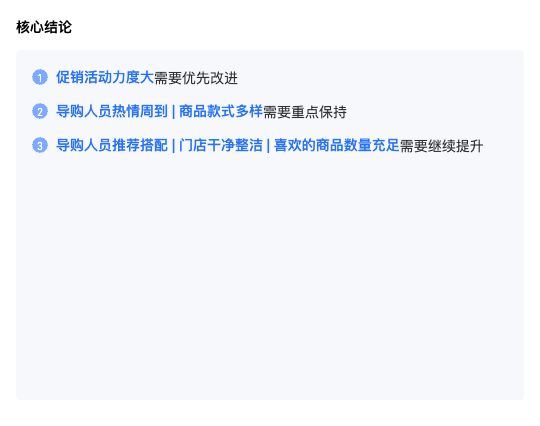
模型根据“要素重要性-NPS矩阵分析图”自动生成核心结论,包括需要优先改进、重点保持、继续提升,以及有余力时可以改进的要素。
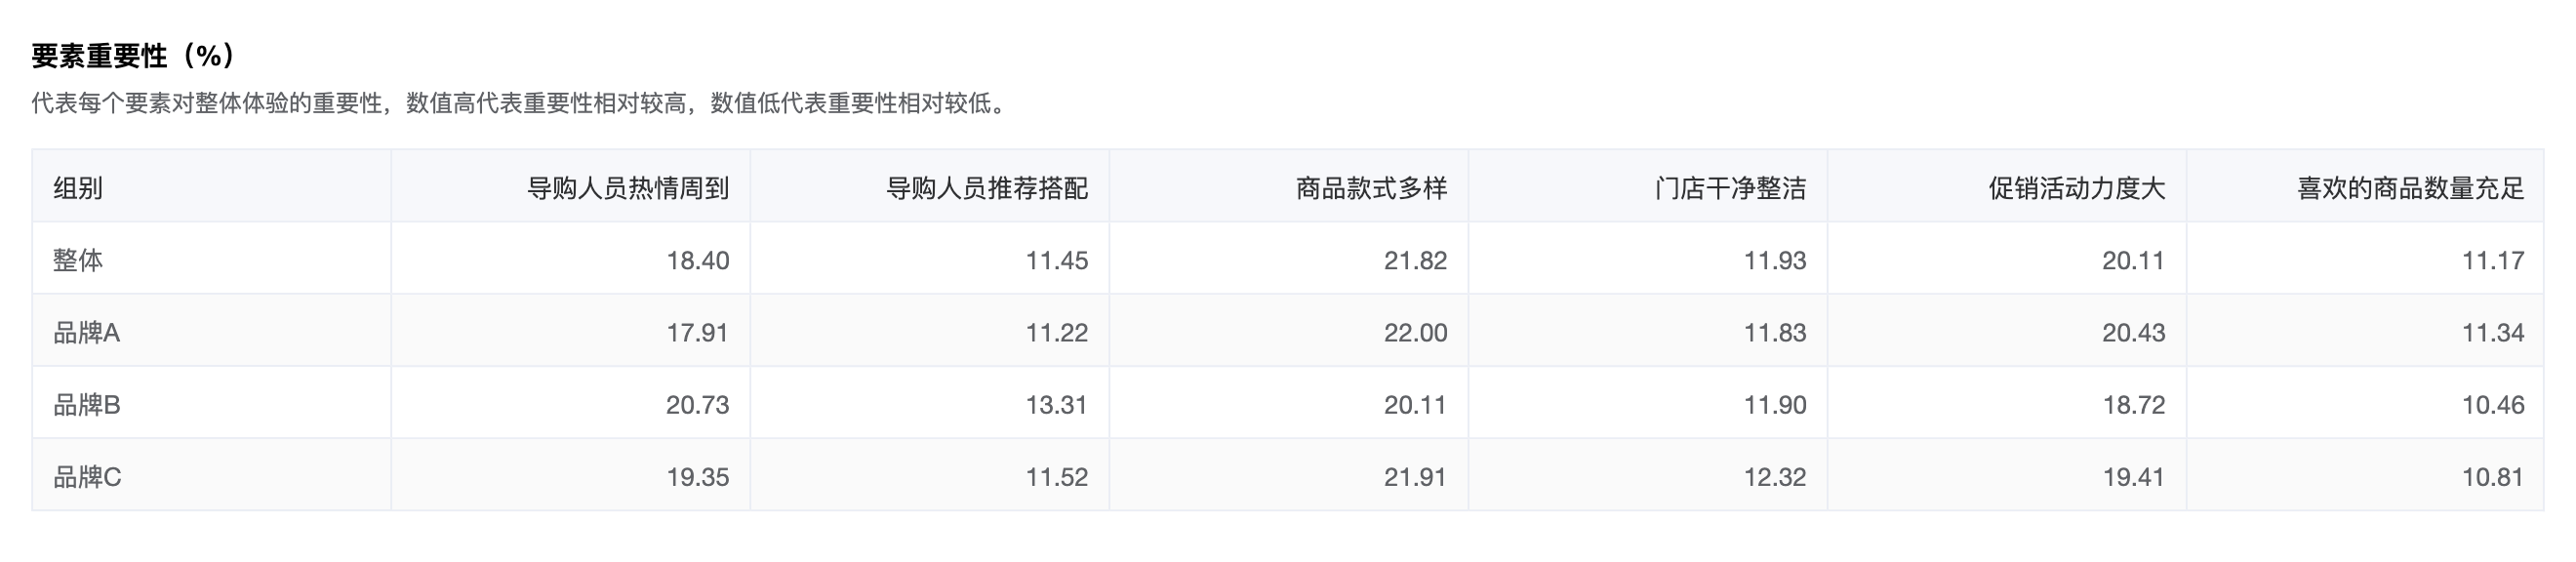
(4)要素重要性(%)
代表每个要素对整体体验的重要性,数值高代表重要性相对较高,数值低代表重要性相对较低。表头取要素的正向表达。
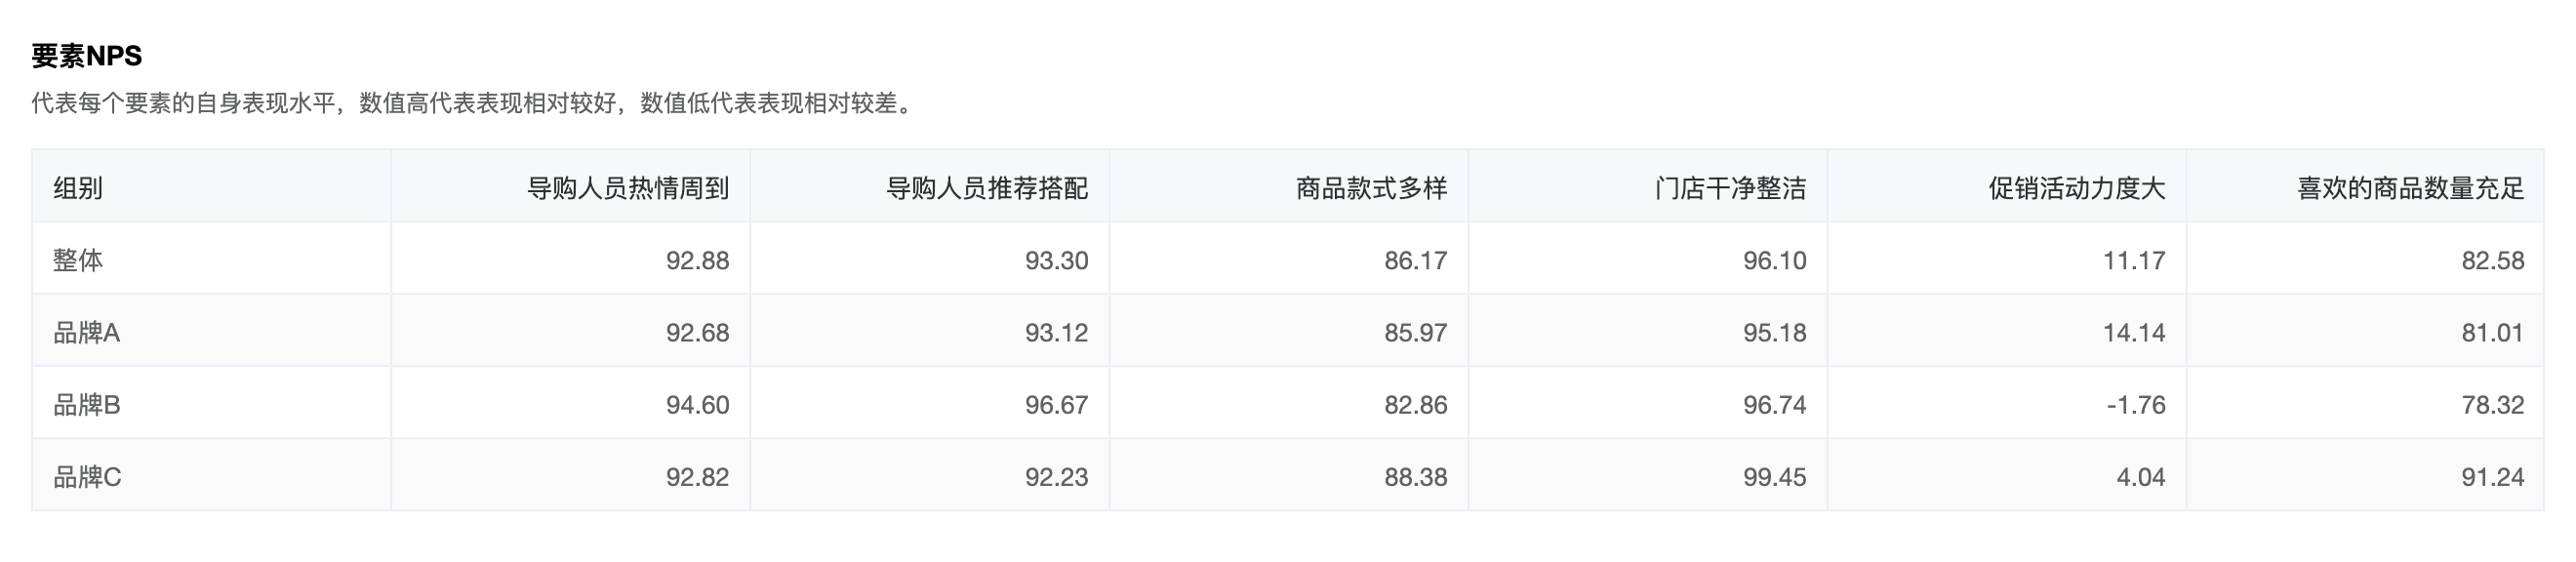
(5)要素NPS
代表每个要素的自身表现水平,数值高代表表现相对较好,数值低代表表现相对较差。
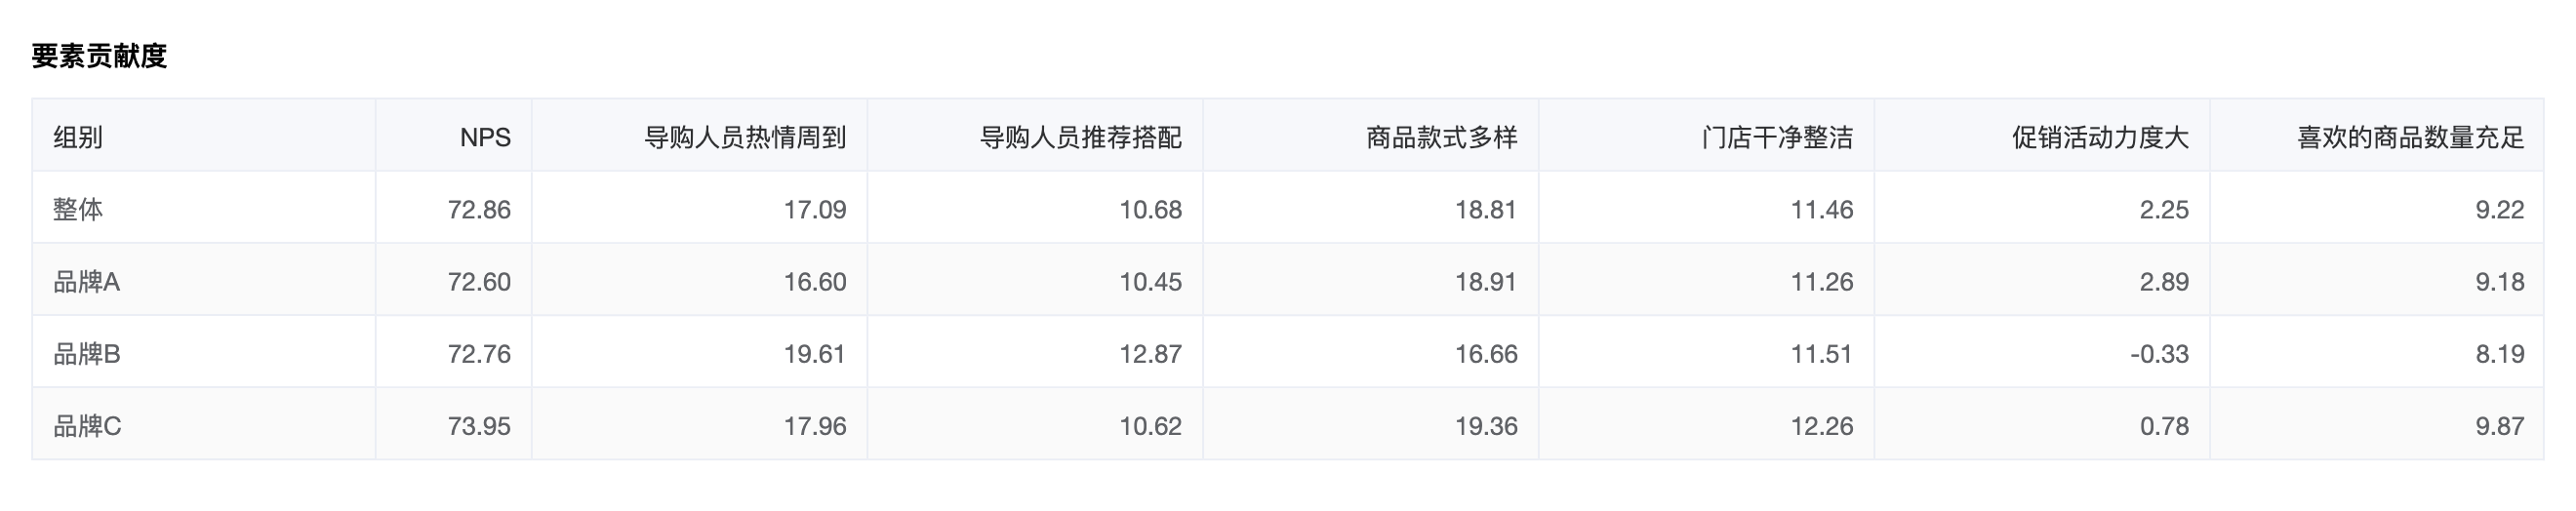
(6)要素贡献度
代表每个要素对整体体验表现水平的贡献程度。影响力大且表现好的要素,能明显提升整体体验,而具体为整体体验提升贡献了多少,就是贡献度的结果。
(7)筛选器
如果配置了分组,那么在页面顶部会有分组筛选器,默认选中“整体”。如果问卷中配置了“其他”选项,那么在页面顶部会有“显示其他”的筛选器。不论是否显示“其他”选项,在数据层面该选项始终会参与计算,筛选器仅影响图表展示效果。