需求优先级排序(KANO)
需求优先级排序(KANO)模型概述
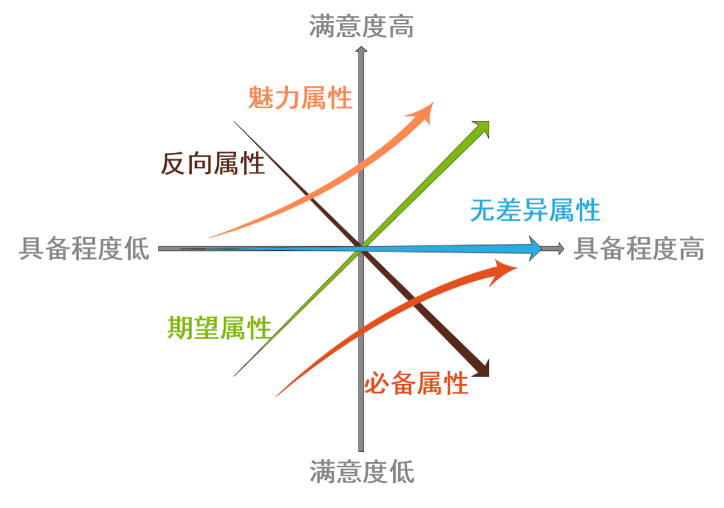
KANO理论模型是东京理工大学教授狩野纪昭(Noriaki Kano)于20世纪80年代提出的,他以自己的名字命名该模型。第一次将满意与不满意标准引入质量管理领域,首次提出了满意度的二维模式,有效解决日本如何提高产品和企业服务的难题。
KANO理论模型原本是用于体现产品功能和用户满意度之间的多样化关系。但由此衍生出来的KANO分析模型(需求优先级分析)则基于一套“标准化”的问卷及分析算法,成为了一种评估需求/功能期待优先级排序的方法。
需求优先级分析(KANO)模型的主要适用场景
该模型主要应用于产品研发(迭代&创新)和市场营销(传播重点寻找)。比如,确认需求/功能期待是否存在,评估需求/功能期待的优先级,为产品的最优配置/功能组合提供参考,打造爆款的传播要素。
问卷设计
(1)正向题和负向题
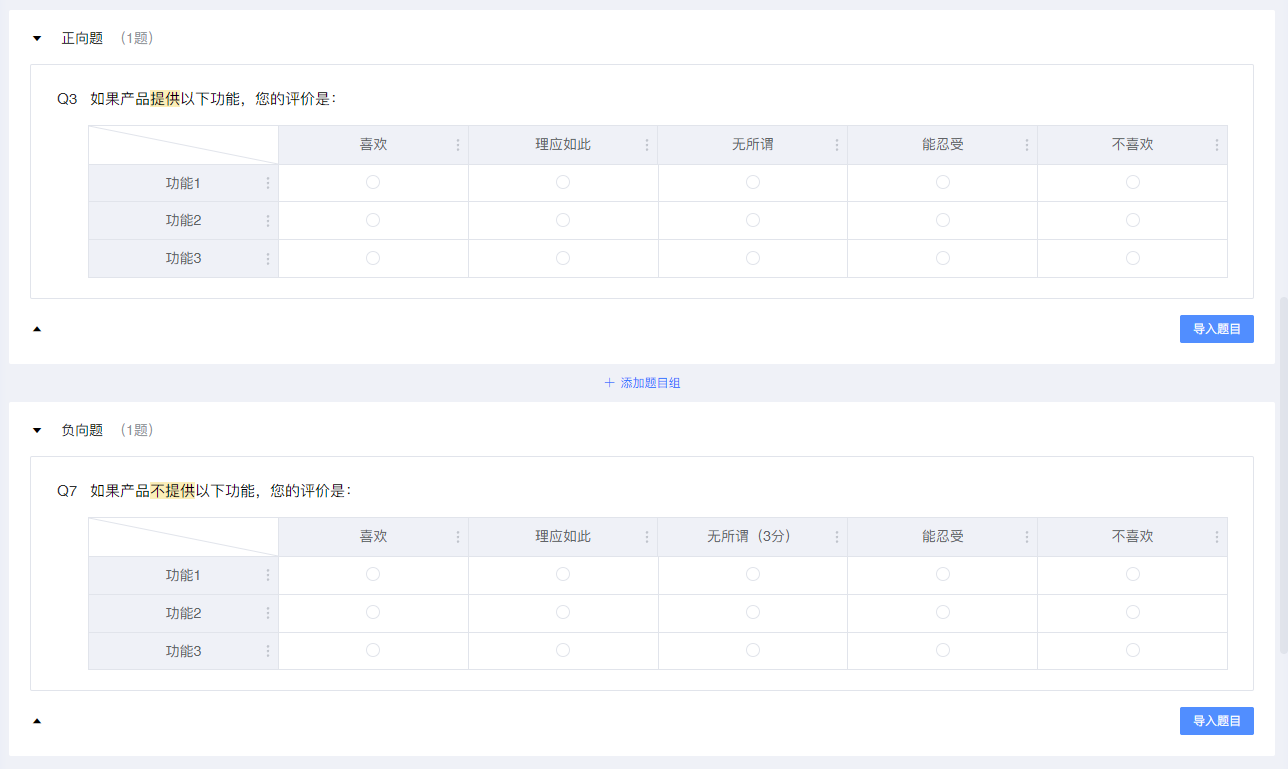
该模型的问卷由两部分组成:正向题和负向题。 “正向题”是指假设产品拥有该项功能用户的满意情况,“反向题”是指假设产品不拥有该项功能用户的满意情况。正向题和负向题均为矩阵单选,选项包括喜欢、理应如此、无所谓、能忍受、不喜欢这五个等级。矩阵行即功能点。正向题和负向题的选项内容和顺序需要严格对应。以下图为例,正向题的第一行是“功能1”,那么负向题的第一行也应该是“功能1”。
(2)注意事项
为保证正常生成分析报告,请按照以下说明操作,并注意界面的提示信息。
- 请不要删除预置的题目和题目组,即使删除后再添加相同的题目或题目组,也会影响分析报告的生成。
- 选项,即喜欢、理应如此、无所谓、能忍受、不喜欢这5个等级: 喜欢(5分):感到满意、开心、惊喜 理应如此(4分):觉得是应该的、必备的 无所谓(3分):不会特别在意,但还可以接受 能忍受(2分):不喜欢,但是可以接受 不喜欢(1分):感到不满意、失望 请不要修改选项文案、不要调整选项顺序、不要新增或删除选项、不要修改选项编号。
- “正向题”是指假设产品拥有该项功能用户的满意情况,“反向题”是指假设产品不拥有该项功能用户的满意情况。在“正向题”题目组中的题目模型自动判定为正向题,同理,在“负向题”题目组中的题目模型自动判定为负向题。请不要调整题目所属的题目组。如果您需要新增题目,请先新增题目组,并将新题目放置在新题目组中。
- 矩阵行即功能点。正向题和负向题的选项内容和顺序需要严格对应。例如,正向题的第一行是“功能A”,那么负向题的第一行也应该是“功能A”。建议单个功能点文案不超过20字,功能点总数不超过5个。
- 选项和矩阵行均不支持图片。
数据结构
系统将答卷数据解析为可以进行进一步分析的数据结构(见下图),分数和量表的对应关系是喜欢(5分)、理应如此(4分)、无所谓(3分)、能忍受(2分)、不喜欢(1分)

分析报告
(1)样本量
样本量即成功完成答卷数,或者上传文件的数据行数。
(2)Better-Worse矩阵分析图
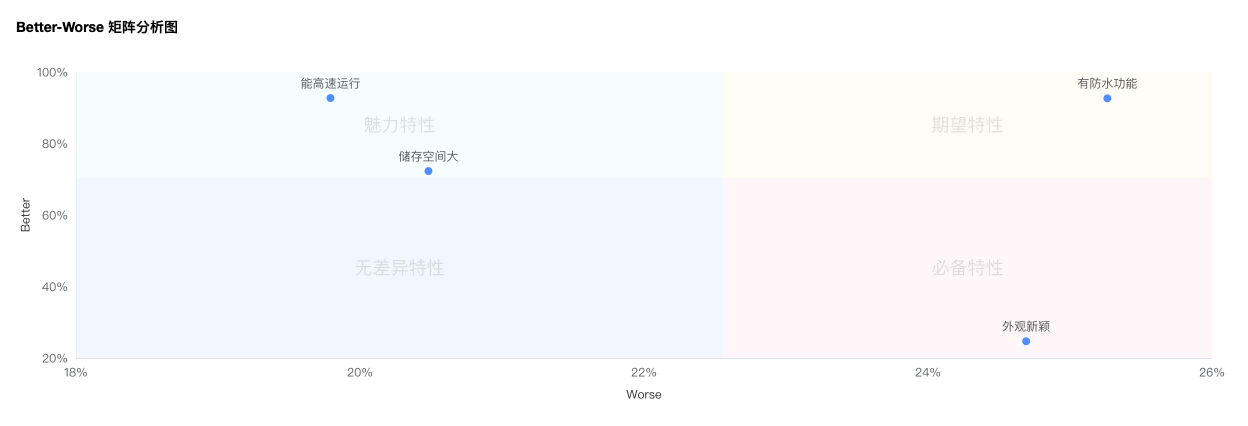
根据Better-Worse系数值将功能点划分为四个类别。
● 期望特性(右上象限):产品提供此功能,用户满意度会提升,当不提供此功能,用户满意度就会降低,这是质量的竞争性属性,应尽力去满足用户的期望型需求。提供用户喜爱的额外服务或产品功能,使其产品和服务优于竞争对手并有所不同,引导用户加强对本产品的良好印象。
● 魅力特性(左上象限):不提供此功能,用户满意度不会降低,但当提供此功能,用户满意度和忠诚度会有很大提升。
● 无差异特性(左下象限):无论提供或不提供这些功能,用户满意度都不会有改变,这些功能点是用户并不在意的功能。
● 必备特性(右下象限):当产品提供此功能,用户满意度不会提升,当不提供此功能,用户满意度会大幅降低。落入此象限的功能是最基本的功能,这些需求是用户认为我们有义务做到的事情。
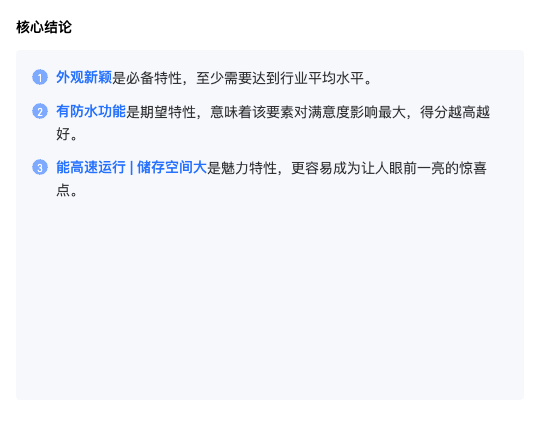
(3)核心结论
模型根据Better-Worse矩阵分析图自动生成核心结论,帮助我们快速理解针对不同特性的产品或服务,应该采取怎样的措施。
(4)模型分析结果
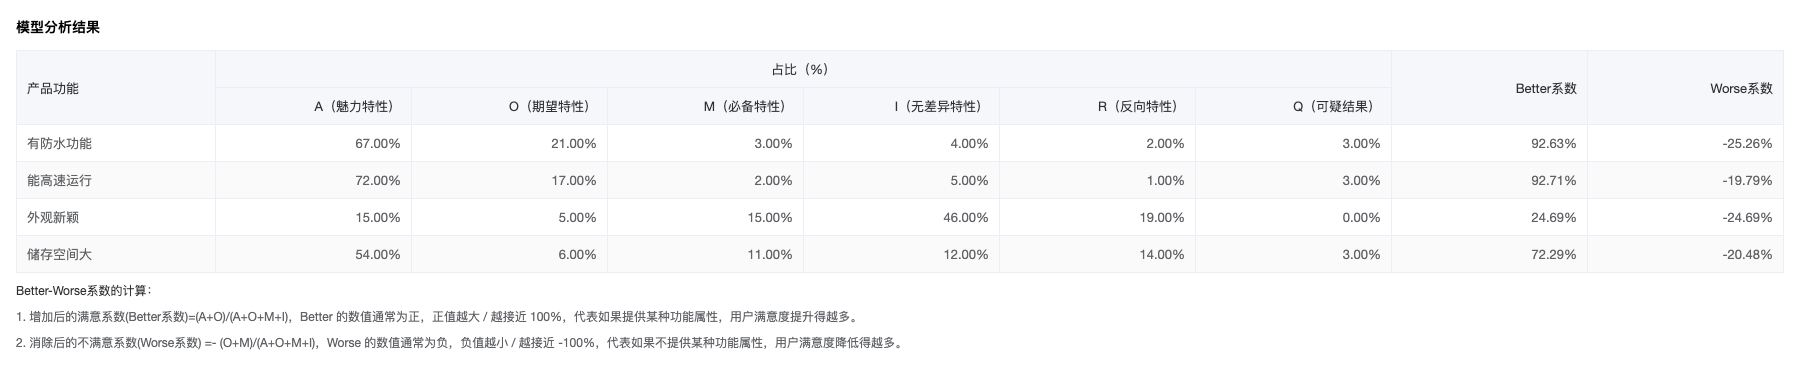
模型分析结果显示了功能点在每一种属性上的占比以及Better-Worse系数,这决定了每个功能点在矩阵图上落在哪个象限。
Better-Worse系数的计算:
增加后的满意系数(Better系数)=(A+O)/(A+O+M+I),Better 的数值通常为正,正值越大 / 越接近 100%,代表如果提供某种功能属性,用户满意度提升得越多。
消除后的不满意系数(Worse系数) =- (O+M)/(A+O+M+I),Worse 的数值通常为负,负值越小 / 越接近 -100%,代表如果不提供某种功能属性,用户满意度降低得越多。
(5)模型定位对照表
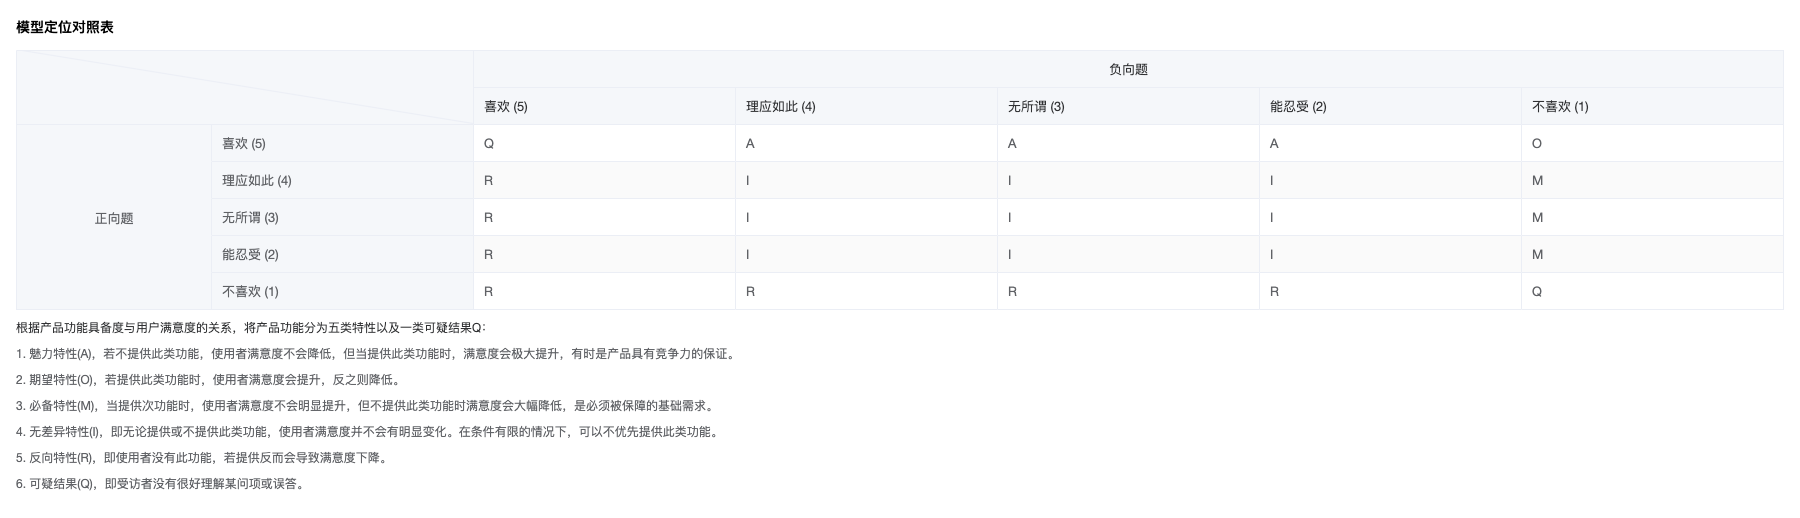
根据产品功能具备度与⽤户满意度的关系,将产品功能分为五类特性以及⼀类可疑结果Q:
● 魅⼒特性(A),若不提供此类功能,使⽤者满意度不会降低,但当提供此类功能时,满意度会极⼤提升,有时是产品具有竞争⼒的保证。
● 期望特性(O),若提供此类功能时,使⽤者满意度会提升,反之则降低。
● ⽆差异特性(I),即⽆论提供或不提供此类功能,使⽤者满意度并不会有明显变化。在条件有限的情况下,可以不优先提供此类功能。
● 反向特性(R),即使⽤者没有此功能,若提供反⽽会导致满意度下降。
● 可疑结果(Q),即受访者没有很好理解某问项或误答。